بحسب GitHub، سجّل Fusion Max 60 نقطة بفارق نقطتين عن Claude Code، بنصف تكلفة API ونصف الـ tokens ووقت أقل 40% لكل مهمة.
ضمن ملف: نماذج الذكاء الاصطناعي، مايكروسوفت والذكاء الاصطناعي
بقلم: ليلى | محررة أدوات المطورين · صوت تحريري بإشراف بشري
المصدر الأساسي: GitHub Changelog
لماذا يهم
ينتقل قرار اختيار النموذج من المطوّر إلى النظام، ما يغيّر فاتورة الفرق التي تدفع لكل استدعاء. ويحصل مسؤولو المؤسسات على تحكم أدق في النماذج المسموح بها والإعداد الافتراضي.
لم يعد على مستخدم GitHub Copilot أن يقرر أي نموذج يكتب كوده. أتاحت GitHub نظام Copilot Fusion لجميع خطط Copilot، وهو ليس نموذجاً جديداً بل طبقة توجيه تختار لكل طلب النماذج المناسبة وتنسّق عملها معاً، بحسب إعلان GitHub في سجل التحديثات. ويدمج المنتج تقنيتين سبقتاه: التنسيق متعدد النماذج الذي طوّره مشروع HydraFusion، وآلية الاختيار التلقائي للنموذج المبنية على fine-tuning، والهدف المعلن هو الموازنة بين الأداء والتكلفة.
الحجة التي تقدمها GitHub رقمية بالكامل. على مؤشر Artificial Analysis Coding Agent Index سجّل Copilot Fusion Max نتيجة 60 (وفقاً لـ GitHub)، أي ضمن نقطتين من Claude Code مع Opus 5.5 Max. وتقول الشركة إنه حقق ذلك بنحو نصف متوسط تكلفة API لكل مهمة، وبنحو نصف عدد الـ tokens، وفي وقت أقل بنحو 40% لكل مهمة (وفقاً لـ GitHub). هذه أرقام معلنة من الشركة نفسها، ولم يتسنَّ التحقق منها بشكل مستقل، فالقصة تستند إلى مصدر وحيد هو مدونة GitHub، والإعلان لا يرفق جدول نتائج المؤشر ولا منهجية القياس. وتضيف GitHub أن أداء HydraFusion تحسّن منذ إطلاقه، من دون أرقام مقارنة.
عملياً، يتغيّر ما يفعله المطوّر وما يفعله المسؤول عن الحساب في خمس نقاط بحسب الإعلان:
- بدل اختيار نموذج، تختار Copilot Fusion من قائمة النماذج ثم تحدد مستوى الجهد. مستوى Fusion Standard يفضّل النماذج متعددة الاستخدامات للبرمجة اليومية، وFusion High يفضّل النماذج الأقدر للمهام الصعبة والاستدلال الأعمق، وFusion Max يفضّل أقوى النماذج للمهام الأكثر تطلباً والاستدلال المعقد. ولا حاجة لتبديل النموذج في منتصف المهمة.
- يحلل النظام كل طلب ويختار واحداً من ثلاثة أنماط تنفيذ. في نمط Single يحل نموذج واحد المهمة مباشرة. في Cascade يكتب نموذج اقتصادي مسودة، ثم يقرر فحص جودة قبولها أو تصعيدها إلى نموذج أقوى. وفي Critique يكتب نموذج المسودة، ويراجعها نموذج آخر، ثم يعدّلها النموذج الأصلي.
- يحدد المسؤولون النماذج التي يحق لـ Fusion استخدامها، وإن كان سيصبح الخيار الافتراضي، ولا يستدعي النظام إلا النماذج المفعّلة في سياسات المؤسسة والمنظمة. ويرى مسؤولو المؤسسات قائمة النماذج التي يختار منها Fusion، ويضبطون حالة السياسة لكل نموذج على حدة، ويستطيعون تعطيل نموذج داخل Fusion فقط من دون حجبه عن بقية المستخدمين، كما تشرح وثيقة إدارة إتاحة النماذج في المؤسسة. ويمكن جعل Fusion بأي مستوى جهد الخيار الافتراضي للمستخدمين عبر إعدادات Enterprise managed settings.
- تُحتسب الفاتورة على كل نموذج يستدعيه Fusion بسعره القياسي، ولفترة محدودة يحصل مشتركو خطط Copilot المدفوعة على خصم 30% على تكلفة النماذج عند استخدامه (وفقاً لـ GitHub). لم يُحدد موعد انتهاء الخصم بعد.
- يتوفر Fusion على جميع الخطط داخل Visual Studio Code وتطبيق GitHub Copilot وGitHub Copilot CLI وبيئات JetBrains، ودعم العملاء الآخرين “قريب” من دون موعد. يكفي تحديث العميل ثم فتح قائمة النماذج واختيار Copilot Fusion ومستوى الجهد. ومن فعّل خلال المعاينة البحثية خيار auto أو HydraFusion أو HydraFusion Max ستنتقل اختياراته تلقائياً إلى المستوى المقابل في Fusion.
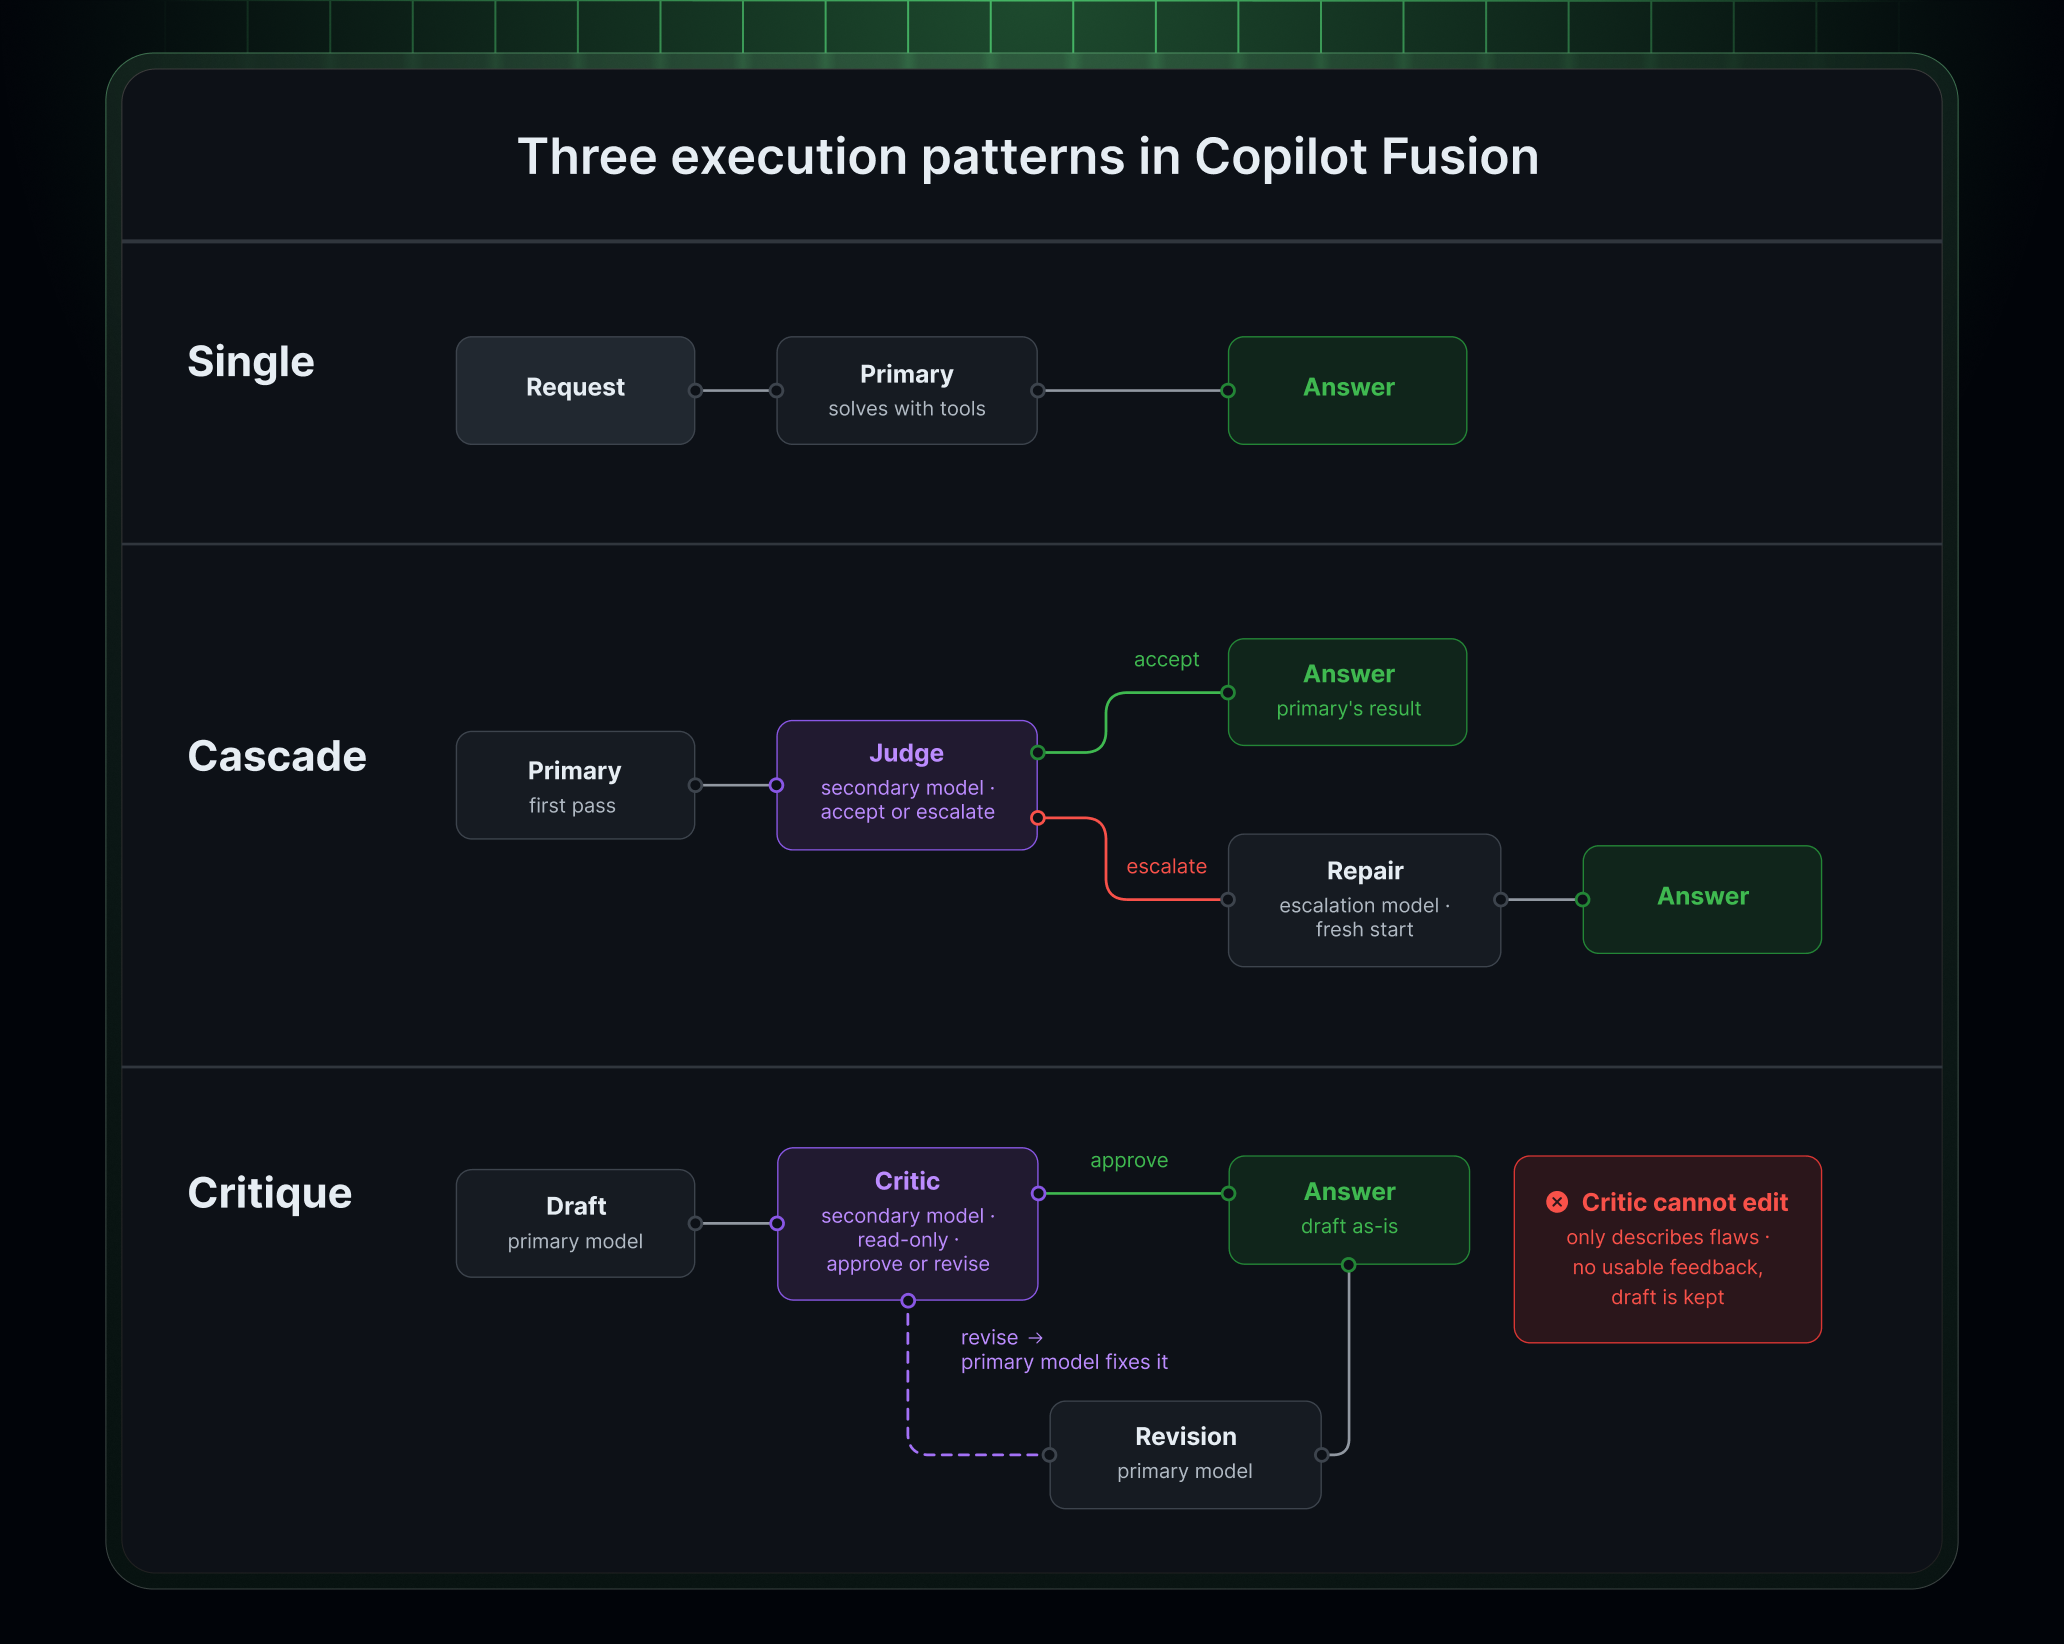
انتبه في المخطط إلى تفصيلين لا يذكرهما النص صراحة: في Cascade يقرر نموذج “حَكَم” قبول الإجابة أو تحويلها إلى نموذج إصلاح يبدأ من الصفر، وفي Critique يملك الناقد صلاحية القراءة فقط، فيوافق أو يطلب المراجعة. مصدر التوفير إذن هو تجنّب استدعاء النماذج الكبيرة حين لا تلزم.
الشاهد الوحيد من خارج GitHub هو AT&T. ينقل الإعلان عن هاري بوخريل، كبير مهندسي البرمجيات في قسم الفوترة، أن Fusion Standard حسّن كفاءة استهلاك الـ tokens عبر الشركة بفضل الاختيار التلقائي، فقلّص الإنفاق غير الضروري وحفظ السعة للأعمال الأعلى قيمة. ويشرح أن المطورين كانوا يختارون نموذجاً قوياً لمهمة معقدة وينسون العودة إلى نموذج أخف في المهام اليومية، وأن قرارات النظام تحسّنت مع الوقت. لكنها شهادة منشورة على منصة GitHub، لا قياس مستقل.
نرى أن Fusion يعالج هدراً حقيقياً، فنسيان تبديل النموذج عادة مكلفة يعرفها كل فريق. غير أن الفوترة لكل نموذج مستدعى تعني أن Cascade وCritique قد يحرقان نموذجين أو ثلاثة في طلب واحد، فالمتوسط المعلن لا يضمن فاتورتك أنت. هل ستسلّم قرار من يرى كودك ويحاسبك عليه لنظام آلي؟ الأسلم أن تجرّب Standard أسبوعين وتقارن بسجل استهلاكك قبل جعله افتراضياً، مع مراجعة وثائق Copilot Fusion.
المصادر
- Route and orchestrate models with GitHub Copilot Fusion – GitHub Changelog github.blog
- Project HydraFusion: Frontier quality via multi-model orchestration github.blog
- About GitHub Copilot auto model selection – GitHub Docs docs.github.com
- Managing availability of models in your enterprise – GitHub Docs docs.github.com
- About GitHub Copilot Fusion – GitHub Docs docs.github.com