من 99.7% إلى 98% على أوراق arXiv، ومن 86.8% إلى 46.6% على 2.68 مليون مقطع، فالاختبار الصغير لم يتنبأ بالكبير.
ضمن ملف: نماذج الذكاء الاصطناعي
بقلم: نور | محررة الأبحاث والدراسات · صوت تحريري بإشراف بشري
المصدر الأساسي: Towards Data Science
لماذا يهم
الفرق التي تقيّم أنظمة RAG على مجموعات صغيرة وأسئلة مكتوبة من الوثائق نفسها قد تحصل على ثقة زائفة لا تصمد عند حجم الإنتاج، وعليها إعادة تصميم اختباراتها.
قد يكون الاختبار الذي يطمئنك على نظام RAG في المختبر هو نفسه ما يضللك. بحسب تجربة منشورة على Towards Data Science، وضع BM25 مقطعاً صحيحاً ضمن أول عشر نتائج في 86.8% من الأسئلة على مجموعة من 10 آلاف مقطع من ويكيبيديا، ثم هبطت النسبة إلى 46.6% على المجموعة الكاملة البالغة 2,681,468 مقطعاً، أي خسارة تقارب 40 نقطة. الطريقة نفسها كانت قد حققت 99.7% على 100 ورقة من arXiv و98% على 1,801 ورقة (وفقاً لـ Towards Data Science). الاختبار الصغير لم يتنبأ بالكبير، وهذه هي القصة كلها.
القصة تقوم على مصدر وحيد هو الكاتب الذي صمم التجربة وأجراها بنفسه، ولم يتسنَّ التحقق من نتائجها بشكل مستقل. لكنه نشر الكود والأسئلة والتصنيفات والنتائج في مستودع علني على GitHub، فيمكن لأي فريق إعادة القياس. سؤاله كان عملياً: في نظام RAG يجيب النموذج اللغوي اعتماداً على مقاطع جلبتها مرحلة بحث مسبقة، فكم مرة تفوّت هذه المرحلة الوثيقة الصحيحة كلما كبرت المجموعة؟ وهل يهم أن تشبه الوثائق الإضافية الإجابة الصحيحة؟ يسمي الكاتب كل وثيقة لا تجيب عن السؤال “مشتتاً” (distractor)، بعضها عشوائي وبعضها قريب جداً من موضوع الوثيقة الصحيحة.
أكثر ما يستحق الانتباه أن الكاتب ثبّت معيار الفشل قبل تشغيل أي شيء، كي لا يختار العتبة بعد رؤية النتائج. بحسب التجربة، لا يُعد حجمٌ ما نقطةَ تدهور إلا إذا هبطت الدرجة 5 نقاط مئوية على الأقل عن أصغر مجموعة، أي أن سؤالاً إضافياً من كل 20 يفقد إجابته. واشترط أن يكون التراجع حقيقياً لا وليد الصدفة، فاعتمد نطاق الثقة 95%، وهو المدى الذي يقع فيه التراجع الحقيقي على الأرجح. مثاله ميزان حمّام يخطئ بنحو 2 كيلوغرام في الاتجاهين: إن أظهر خسارة كيلوغرام فلا تعرف هل خسرت شيئاً، وإن أظهر 8 كيلوغرامات فقد خسرتها فعلاً. وعليه، تراجع بـ6 نقاط بنطاق يمتد من هبوط 9 نقاط إلى ارتفاع نقطة واحدة لا يُحتسب لأنه يشمل احتمال “لا تغيير”، أما إن امتد النطاق من هبوط 9 إلى هبوط 3 فيُحتسب (وفقاً لـ Towards Data Science).
استخدمت التجربة ثلاثة مقاييس. recall at 5 هو نسبة الأسئلة التي تظهر فيها ورقة مجيبة ضمن أول خمس نتائج، وsuccess at 10 يحتسب السؤال نجاحاً إذا ظهر مقطع موسوم واحد على الأقل ضمن أول عشر نتائج، وexact match يقيس هل طابقت إجابة النموذج إجابة مقبولة.
في الاختبار الأول جمع الكاتب 2,000 ملخص حديث من arXiv في تعلّم الآلة واللغة والبحث، و298 سؤالاً من اختباره السابق للاسترجاع الوكيلي، كُتب كل منها من ورقة واحدة وروجع يدوياً، دون تكرار أي ورقة. لكل سؤال بُنيت مجموعات متداخلة بأحجام 100 و250 و500 و1,000 و1,801 ورقة، تضم كل منها الأصغر منها مع بقاء الورقة الصحيحة دائماً. وأي ورقة أخرى صالحة كمشتت، ومنها 1,702 ورقة بلا أسئلة و297 ورقة تخص أسئلة أخرى (وفقاً لـ Towards Data Science).
المشتتات العادية سُحبت عشوائياً من أوراق بعيدة عن الورقة الصحيحة في ثلاث سحبات منفصلة، والمشتتات المتشابهة هي الأقرب إليها بالترتيب، وقيس التشابه بنموذج embedding صغير منفصل حتى لا تُبنى المجموعات لخداع الطرق المختبرة. وقارن الكاتب BM25 مع embeddings، كلاً منهما بأسلوبين: flat chunks يبحث في نوافذ من جملتين ويعيد أفضل خمس نوافذ، وparent documents يبحث في النوافذ نفسها ويعيد الملخص الكامل لأفضل خمس أوراق مختلفة. أربعة إعدادات، تصبح ثمانية مع نوعي المشتتات.
ولأن ورقة متشابهة قد تجيب عن السؤال مصادفة فتظلم البحث، فُحصت أقرب 50 ورقة لكل سؤال. رصد Claude Haiku 5.5 الأوراق المحتمل أن تجيب، وراجع Claude Sonnet 5.5 كل حالة، فرُصدت 446 حالة برّأ Sonnet منها 313، لكن الكاتب حذف كل الأوراق المرصودة احتياطاً وعوّضها بالتالية في القرب، ولهذا توقفت أكبر مجموعة عند 1,801 لا 2,000. رفض أحد النموذجين سؤالاً واحداً ففُحص يدوياً، ثم قرأ الكاتب عينات من التصنيفات منها 40 ورقة لم يرها النموذجان، فكانت كلها خارج الموضوع بوضوح. ولأنه لم يقرأ كل الأزواج يعامل التصنيفات كنطاق تقريبي. الكلفة الكاملة لاستدعاءات النموذجين: 1.81 دولار (وفقاً لـ Towards Data Science).
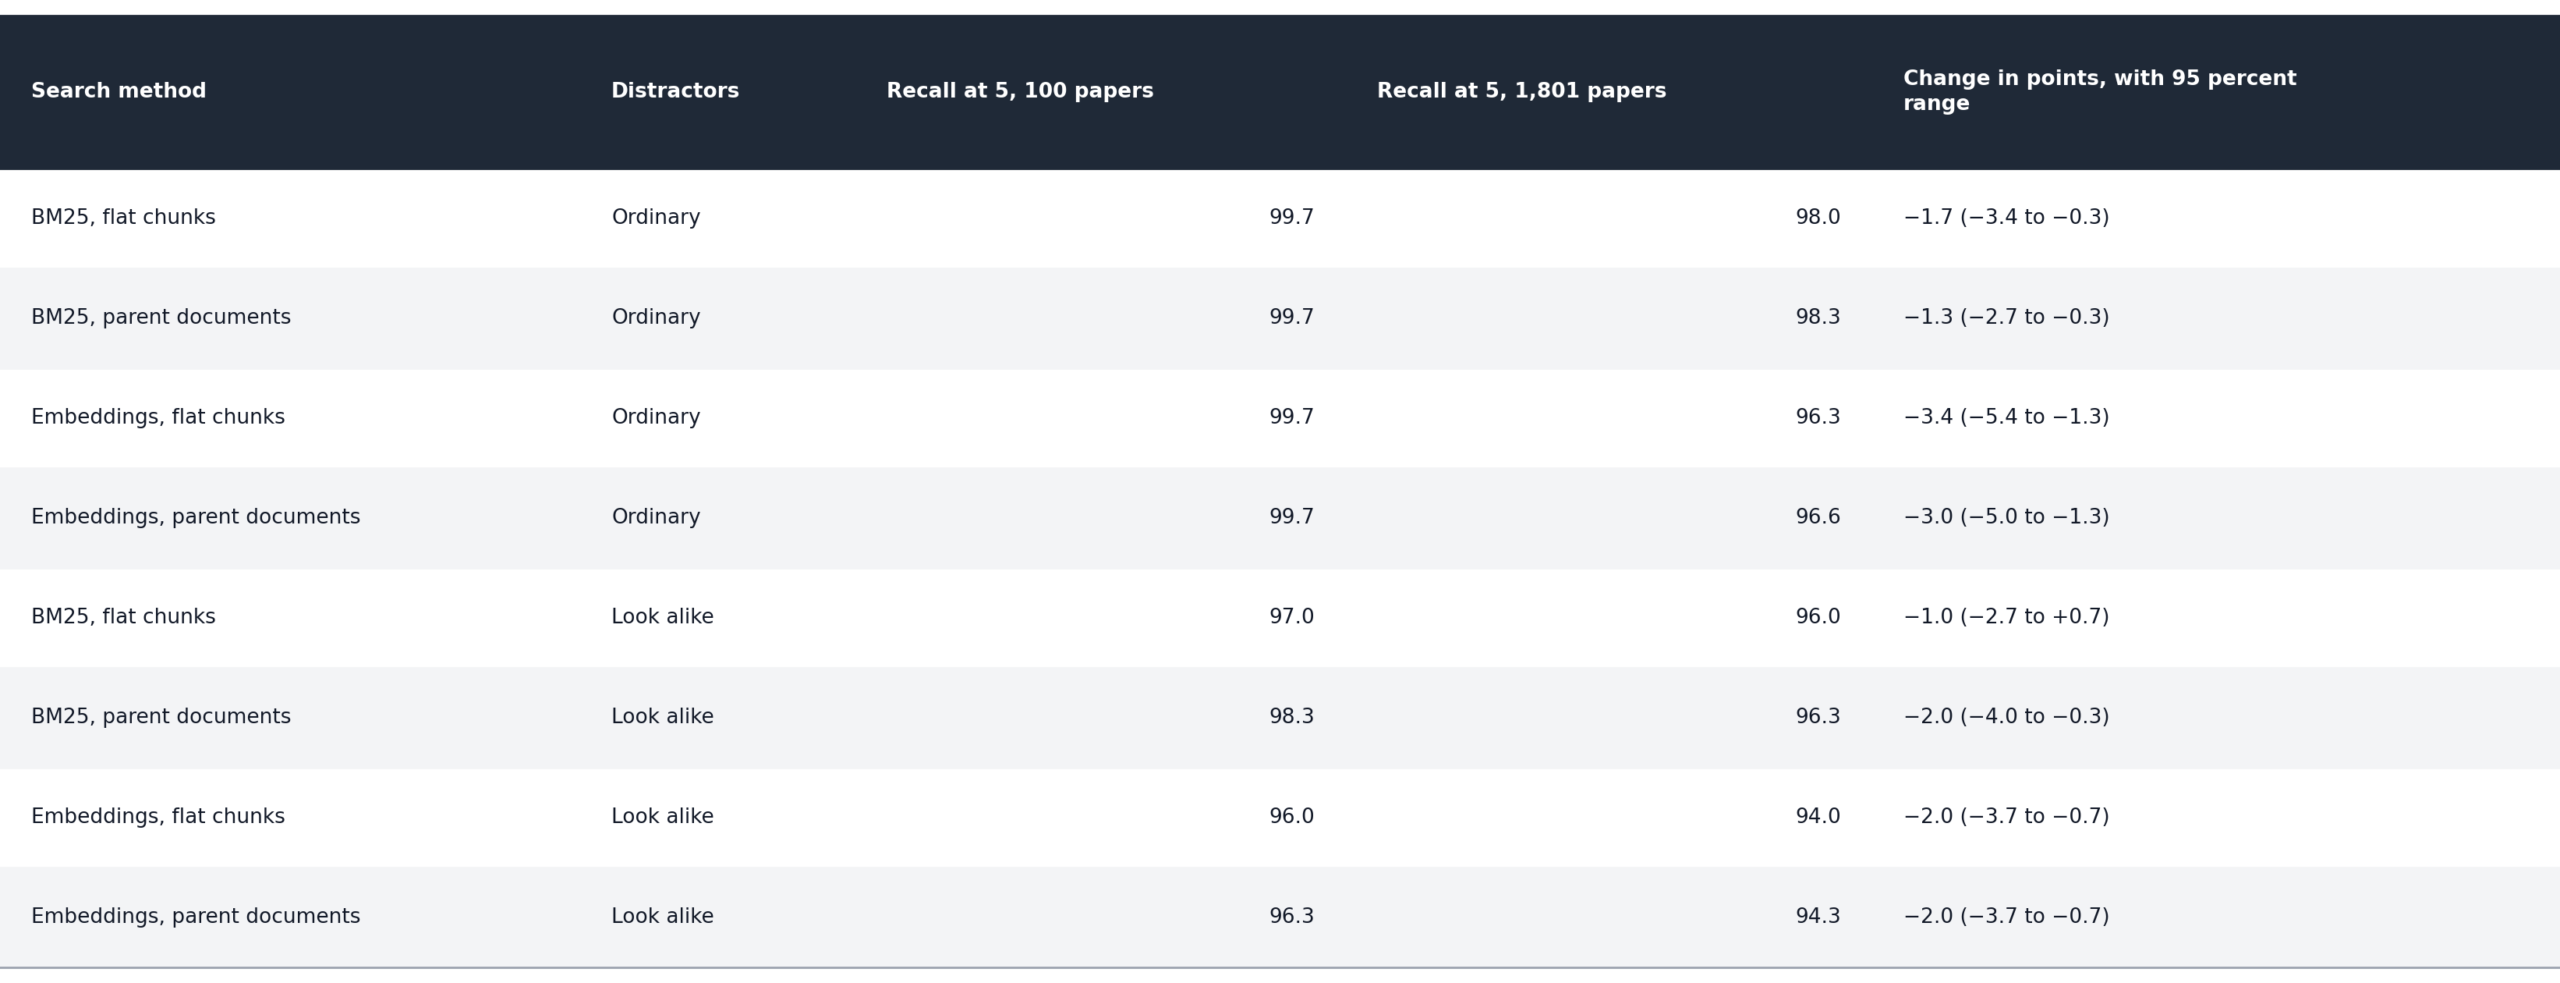
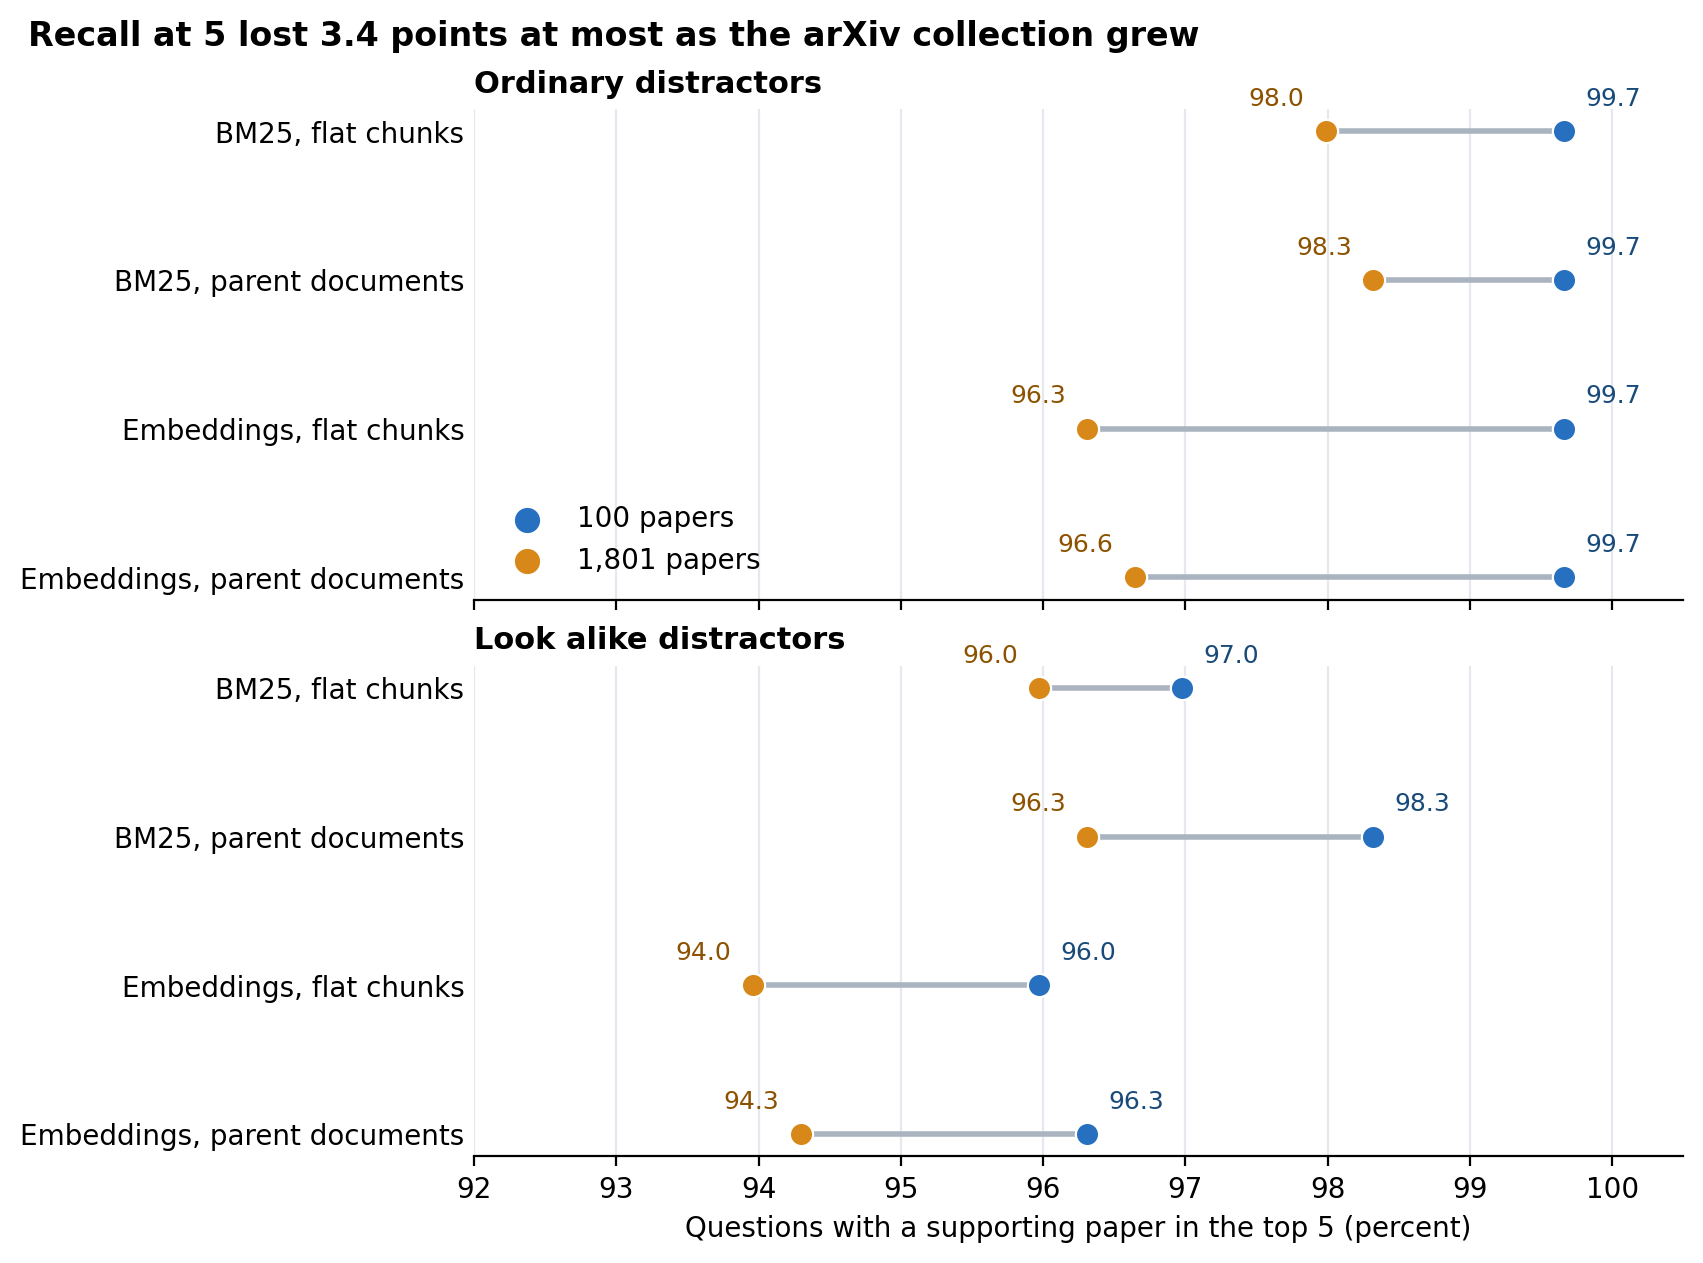
جاءت النتائج على النحو التالي، بحسب الكاتب:
- لم يبلغ أي إعداد عتبة النقاط الخمس على أوراق arXiv. أكبر تراجع كان 3.4 نقطة لدى embeddings مع flat chunks ومشتتات عادية، بنطاق ثقة من 1.3 إلى 5.4 نقطة. وبما أن الحد الأعلى يتجاوز 5، لا يمكن استبعاد تراجع حقيقي يتخطى العتبة بقليل. يشرح الكاتب ذلك بقياس طول 298 بالغاً متوسطهم 170 سنتيمتراً: لن تقول إن متوسط المدينة 170 بالضبط، بل بين 168 و172 على الأرجح (وفقاً لـ Towards Data Science).
- تقدّم parent documents على flat chunks بـ0.3 نقطة في المقارنات الأربع عند 1,801 ورقة، لكن النطاقات متداخلة بشدة فلا يُعد ذلك فوزاً، ولم يقلل ضرر النمو بوضوح: التراجع أصغر في مقارنتين وأكبر في واحدة ومساوٍ في الرابعة. وخسرت embeddings أكثر من BM25 مع المشتتات العادية دون فرق واضح مع المتشابهة، فخيارات التصميم لم تتصرف باتساق (وفقاً لـ Towards Data Science).
- بدأت مجموعات المشتتات المتشابهة أدنى أصلاً، بين 96.0% و98.3% عند أصغر حجم، على الأرجح لأن 99 ورقة متشابهة تنافس الورقة الصحيحة بقوة منذ البداية، ثم كلّف التوسيع نقطة أو نقطتين فقط (وفقاً لـ Towards Data Science).
- صمدت النتيجة أمام ثلاث مراجعات: الاكتفاء بحذف 133 ورقة رصدها النموذجان معاً، واستبعاد ثلاثة أسئلة لا تدعمها أوراقها فعلاً، واستبعاد ثمانية أسئلة تحتاج حقيقة واحدة فقط فلا يمكن لورقة أن تجيب عنها جزئياً. بقي أكبر تراجع في كل نسخة بين 3.1 و3.4 نقطة (وفقاً لـ Towards Data Science).
- على ويكيبيديا انخفضت الدرجة عند كل حجم، وأول حجم استوفى القاعدة كان 100,000 مقطع بتراجع 11.1 نقطة ونطاق من 10.2 إلى 12.1، وانتهت المجموعة الكاملة أدنى بنحو 40 نقطة من نتيجة 10 آلاف مقطع (وفقاً لـ Towards Data Science).
لماذا يختلف الاختباران إلى هذا الحد؟ يعترف الكاتب بأن الأول كان سهلاً: الدرجات بدأت قرب 100% فلم يبقَ مجال للسقوط، والمجموعة توقفت عند ألفي ورقة بينما مخازن الوثائق الحقيقية أكبر بكثير، والأسئلة كُتبت من الورقة التي تسأل عنها فتشاركها المفردات على الأرجح، وهذا يسهّل مهمة البحث ويخفي سلوكه أمام أسئلة يكتبها مستخدمون حقيقيون. لذلك انتقل إلى Natural Questions، وهي استعلامات بحث حقيقية مجهولة الهوية حُددت إجاباتها على صفحات ويكيبيديا، في نسختها ضمن حزمة BEIR التي تضم 3,452 سؤالاً و2,681,468 مقطعاً وأحكام صلة بشرية، أي وسماً يقول إن مقطعاً ما يساعد في الإجابة، ويعمل كمفتاح الإجابات في آخر الكتاب المدرسي (وفقاً لـ Towards Data Science).
خصص الكاتب 40 سؤالاً لفحص الكود واستخدم 3,412 في اختبار الحجم، لكل منها مقطع موسوم واحد على الأقل، مع BM25 وحده. بنى مجموعات متداخلة بأحجام 10,000 و100,000 و500,000 و1,000,000 مقطع، لكل منها ثلاث سحبات عشوائية، وشغّل المجموعة الكاملة مرة واحدة. ضمت كل مجموعة جميع المقاطع الموسومة، وامتلأ الباقي بمقاطع بلا وسم (وفقاً لـ Towards Data Science).
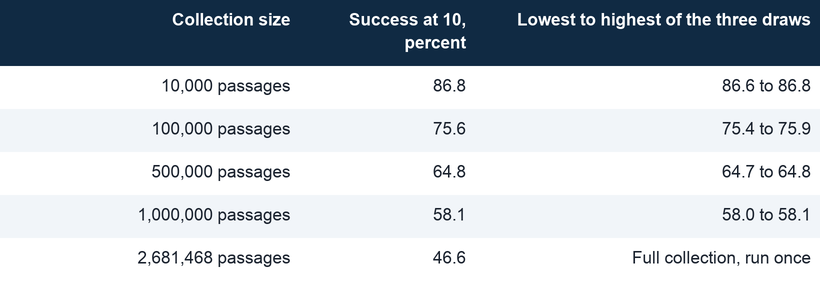
خسر BM25 نقطتين على الأكثر مع أوراق arXiv، وخسر 40 هنا. لكن الاختبارين يختلفان في الموضوع وأسلوب الأسئلة والتصنيفات والحجم، فلا يمكن تحديد العامل الحاسم، بحسب الكاتب. ويضيف تحفظاً جوهرياً: التصنيفات إيجابية فقط، والمقطع غير الموسوم قد يجيب ومع ذلك يُحتسب إخفاقاً. في سؤال عن أعلى جبل قد يحمل مقطع واحد الوسم بينما تذكر مقاطع أخرى إفرست أيضاً. وفي اختبار الإجابة، لم يصل أي مقطع موسوم إلى أول عشر نتائج في 21 من 210 أزواج من الأسئلة والسحبات العادية، ومع ذلك أصاب نموذج الإجابة في 5 منها (وفقاً لـ Towards Data Science). جزء من الأربعين نقطة إذن قد يكون خسارة في القياس لا في البحث. النص المتاح لنا ينقطع عند هذه النقطة، فلم نطّلع على بقية التحفظات ولا على نتائج exact match كاملة.
تقديرنا في موجز أن الرقم الصادم أقل أهمية من الدرس المنهجي. عتبة مثبتة سلفاً، ونطاقات ثقة، وفحص للمشتتات بأقل من دولارين، وكود منشور: هذا ما يغيب عن معظم الادعاءات بأن “الـ RAG يعمل جيداً”. وإذا كنت تبني نظام استرجاع لمستندات شركتك وقيّمته على بضعة آلاف وثيقة وأسئلة كتبها فريقك من الوثائق نفسها، فأنت على الأرجح تقيس الحالة الأسهل. الكاتب نفسه يطلب قراءة نتائجه دافعاً لاختبار إعدادك، لا قاعدة عامة، وهذا بالضبط ما ينبغي فعله: اختبر على الحجم الذي ستعمل به فعلاً، وباستعلامات حقيقية، وراجع “إخفاقاتك” قبل أن تصدقها.
المصادر
- A RAG Search Test That Passed on 2,000 Papers Missed 40 More Answers per 100 at 2.68M towardsdatascience.com
- Does Agentic RAG Actually Retrieve Better Evidence? I Tested It on 298 Questions towardsdatascience.com
- GitHub – abduldattijo/distracting-evidence-rag-test: Code, data and results for testing how much distracting evidence a RAG pipeline can handle github.com
- Natural Questions: a Benchmark for Question Answering Research research.google
- BEIR: A Heterogenous Benchmark for Zero-shot Evaluation of Information Retrieval Models arxiv.org