حد المخرجات يقفز من 64 ألفاً إلى مليون توكن، والوصول يبدأ بمدافعي الأمن بلا حواجز سيبرانية قبل المطورين والمشتركين.
ضمن ملف: جوجل والذكاء الاصطناعي، نماذج الذكاء الاصطناعي
بقلم: سارة | محررة نماذج الذكاء الاصطناعي · صوت تحريري بإشراف بشري
المصدر الأساسي: Google Blog
لماذا يهم
المطورون والمؤسسات التي تبني وكلاء لمهام طويلة ستحصل على نموذج يُخرج مئات آلاف التوكنات في مسار واحد، بتسعير معروف مسبقاً. أما فرق الأمن فتحصل على أداة لاكتشاف الثغرات وترقيعها قبل أن يصل مثلها إلى العامة.
أعلنت Google في 30 سبتمبر 2026 عن Gemini 4 Argon، نموذجها الجديد من الفئة الحدّية (frontier). لن يصل النموذج أولاً إلى المطورين أو المشتركين، بل إلى مجموعة من مدافعي الأمن السيبراني الموثوقين عبر برنامج Fairwind. نشر الإعلان كوراي كافوكتشوغلو، النائب الأول للرئيس في Google DeepMind وكبير مهندسي الذكاء الاصطناعي في الشركة، بحسب مدونة Google. وتقول الشركة إن النموذج صُمّم للحفاظ على استدلال عميق عبر مهام طويلة ومعقدة في هندسة البرمجيات والعمل المعرفي المؤسسي، مثل القانون والمالية، وفي الدفاع السيبراني.
السعر التمهيدي محدد مسبقاً رغم أن الإتاحة العامة لم تبدأ: 2 دولار لكل مليون توكن إدخال و10 دولارات لكل مليون توكن إخراج، مع خصم 95% على توكنات الإدخال المخزّنة مؤقتاً (cached)، أي نحو 0.10 دولار للمليون (وفقاً لـ Google). أما موعد الإتاحة الأوسع فلم يُحدد بعد. تقول Google إنها ستبدأ بعملاء API المدفوعين ومشتركي Google AI Ultra، ثم تنتقل إلى المطورين والمؤسسات والمستهلكين “في أقرب وقت ممكن”. وتشارك الشركة في المسار الطوعي الذي تتيحه الحكومة الأمريكية للوصول إلى النماذج قبل إطلاقها، وهو مسار قريب من روح ميثاق السلامة الذاتي الذي وقعته شركات الذكاء الاصطناعي مع ترامب.
قبل أن يصل Argon إلى أي عميل، تستخدمه Google داخلياً منذ فترة. تقول الشركة إن آلافاً من موظفيها أشادوا بأدائه في المهام البرمجية المتخصصة والبحث المعمّق وجودة الكتابة. وتذكر مثالين لافتين. في الحوسبة الكمية، ساعد النموذج الباحثين على تحسين موارد “الزمكان” (عدد الكيوبتات مضروباً في عدد البوابات) لإجراءات فرعية تمثّل عنق زجاجة في تطبيقات مهمة، وتفوّق في إحدى الحالات على الخط المرجعي المنشور بنسبة 40% خلال دقائق. وفي كفاءة الذاكرة، حلّل فريق من وكلاء Argon بيانات القياس عبر أسطول مراكز بيانات Google، ثم حدد تحسينات للذاكرة وطبّقها بشكل مستقل. حرّرت هذه التحسينات أكثر من 300 تيرابايت (TiB) بعد نشرها، وتقدّر الشركة الوفر الإجمالي بين 500 تيرابايت و1 بيتابايت (وفقاً لـ Google). هذه كلها أرقام معلنة من الشركة نفسها، ولم يتسنَّ التحقق منها بشكل مستقل.
هذه أبرز قدرات النموذج كما تعرضها Google:
- حد مخرجات يبلغ مليون توكن. رفعت Google حد الإخراج من 64 ألف توكن إلى مليون توكن (وفقاً لـ Google)، وتصفه بأنه الأعلى في القطاع. الفكرة أن النموذج يستطيع توليد مئات آلاف التوكنات في مسار واحد، فيحل مسائل صعبة “دفعة واحدة” دون تقطيعها. انتبه هنا: الملخص الآلي في أعلى الصفحة يتحدث عن “حد مليون توكن” دون تحديد، لكن متن الإعلان واضح في أن الرقم يخص المخرجات.
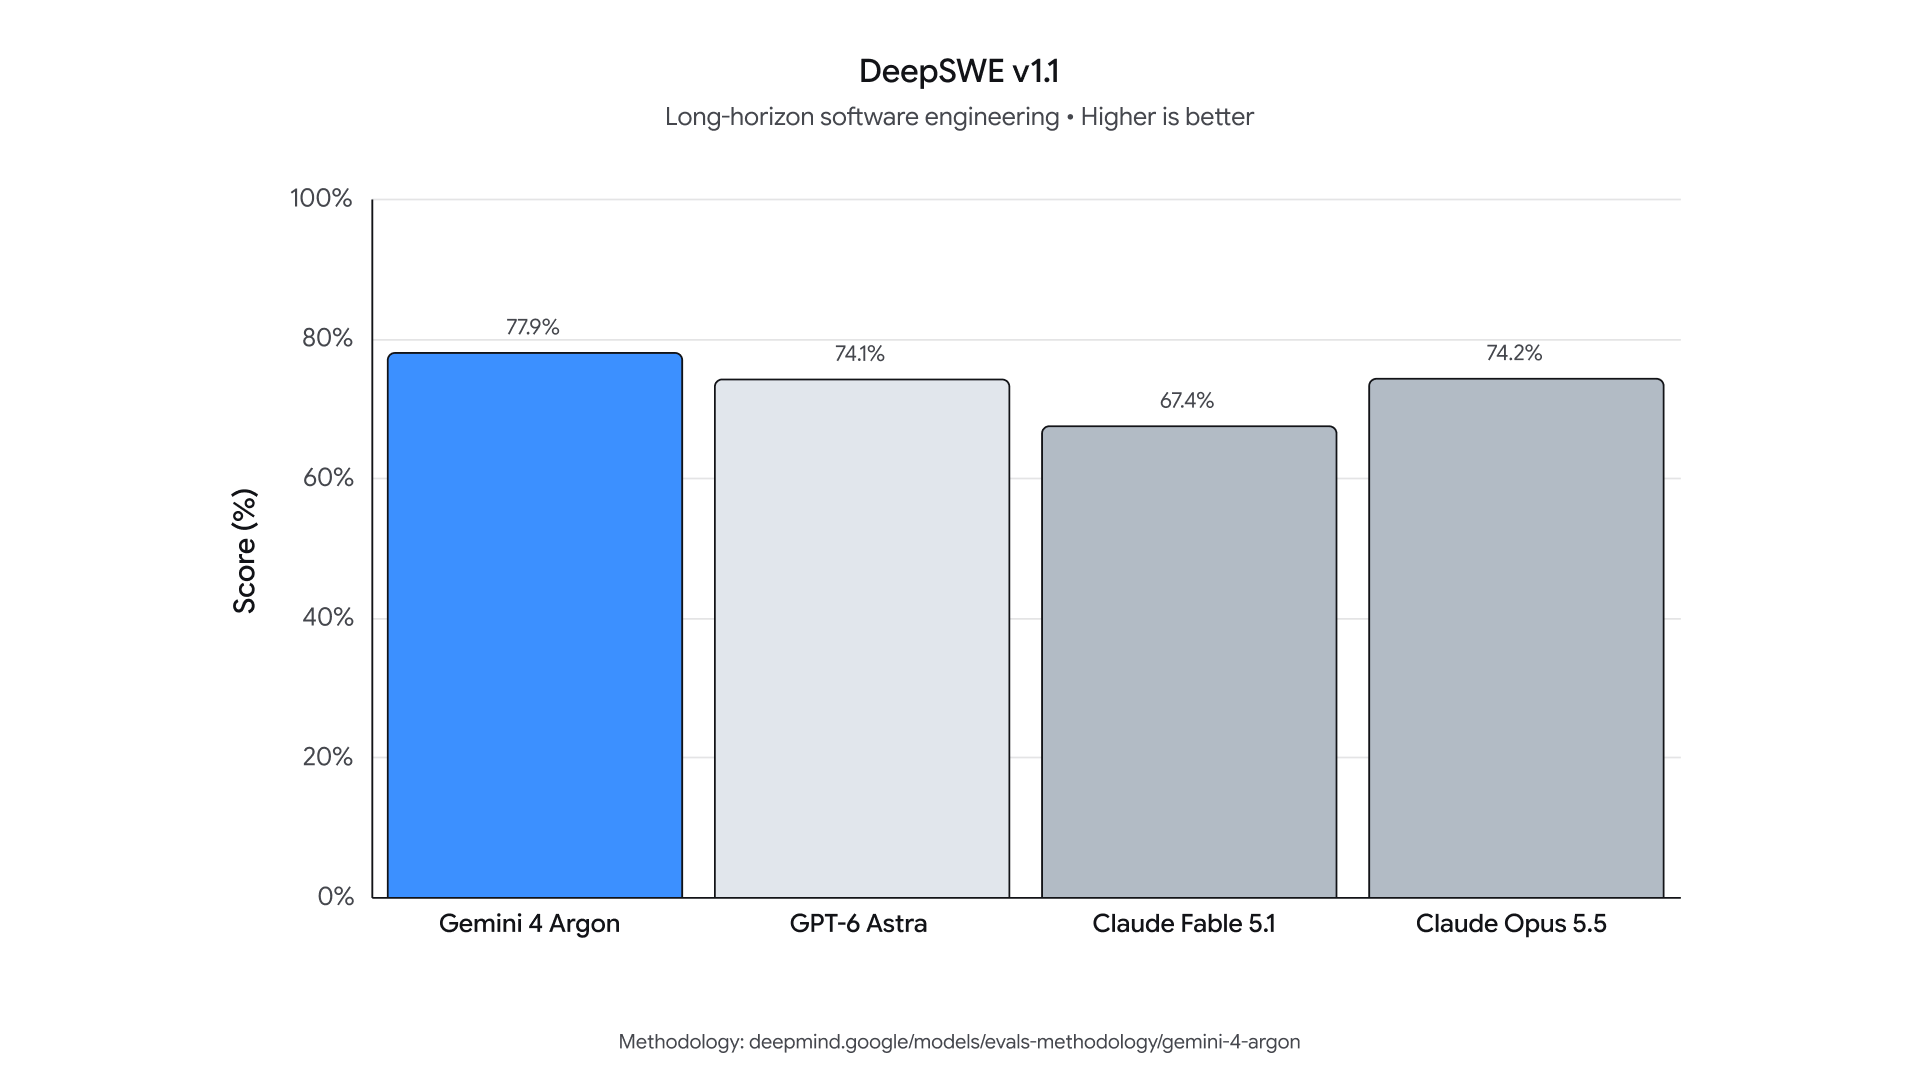
- هندسة برمجيات طويلة المدى. سجّل Argon نتيجة 77.9% على DeepSWE v1.1، وهو معيار يقيس مهام هندسة البرمجيات الواقعية طويلة المدى (وفقاً لـ Google). وتعمل وكلاؤه داخلياً على ترحيل قواعد شيفرة C/C++ إلى Rust، بأحجام تبدأ من عشرات آلاف الأسطر في مكتبات مثل re2 وlibgav1، وتصل إلى أكثر من 800 ألف سطر في نواة Zircon الخاصة بنظام Fuchsia. تخضع هذه الترحيلات لتدقيق آلي ويدوي واختبارات محاكاة قبل وصولها إلى الإنتاج. في libgav1، مكتبة Google مفتوحة المصدر لفك ترميز الفيديو، أخذت الوكلاء نسخة Rust موجودة واستبدلت فيها 32 ألف سطر من شيفرة SIMD. فعلت ذلك عبر جولات متكررة من التجارب الموجّهة بالقياس ودراسة مخرجات المترجم، لتنتج Rust آمنة يحوّلها المترجم إلى تعليمات متجهة تلقائياً. كانت النتيجة مفكك فيديو آمناً على مستوى الذاكرة، أسرع 2.7 مرة من نسخة Rust السابقة، بمخرجات فيديو مطابقة، وأقرب إلى أداء نسخة C++ المحسّنة (وفقاً لـ Google).
- عمل معرفي مؤسسي. تقول Google إن Argon يتصدر مؤشر Vals الذي يقيس الأثر الاقتصادي في المالية والبرمجة والقانون والضرائب، ويزن كل قطاع بحسب مساهمته في الناتج المحلي الأمريكي. وتضيف أنه يحقق أداءً رائداً على Vals Finance Agent v2 للبحث المالي متعدد الخطوات، وعلى معيار Harvey للوكلاء القانونيين في البحث والصياغة القانونية. وعلى AutomationBench، معيار Zapier لتنفيذ وظائف الأعمال الأساسية من البداية إلى النهاية، جاء في المركز الأول بنتيجة 51.3% (وفقاً لـ Google).
- فهم بصري في سياق العمل. يحلل النموذج الرسوم البيانية المهنية، ويلتقط التفاصيل من مقاطع الفيديو الطويلة، وينفّذ إجراءات بناءً على سلسلة من المستندات. وحقق على LVBench لفهم الفيديو الطويل نتيجة 91.7% (وفقاً لـ Google)، وهي أعلى نتيجة على هذا المعيار بحسب الشركة.
- دفاع سيبراني بلا حواجز للموثوقين. درّبت Google النموذج على اكتشاف الثغرات الحرجة والتحقق منها وترقيعها بشكل مستقل. وستتيحه للمدافعين الموثوقين ولفرقها الداخلية دون الحواجز السيبرانية المعتادة. على CWE-bench v1 لمعالجة الثغرات تعادل Argon في المركز الأول بنتيجة 68% (وفقاً لـ Google)، ولم تذكر الشركة النموذج الذي تعادل معه. ويبني هذا الأداء على نتائج Gemini 3.8 Flash Cyber السابقة على CWE-bench v0. وعلى المعيار الداخلي الشامل للثغرات لدى Google، كشف Argon ثغرات عبر قواعد شيفرة بـ20 لغة برمجة. وعلى معيار Wiz الداخلي لاختبار الاختراق “الصندوق الأسود”، الذي يحلل أنظمة ويب حية دون الاطلاع على شيفرتها المصدرية، تفوّق على 3.8 Flash Cyber في رسم سطح الهجوم وتحديد الثغرات وإنتاج أدلة إثبات المفهوم.
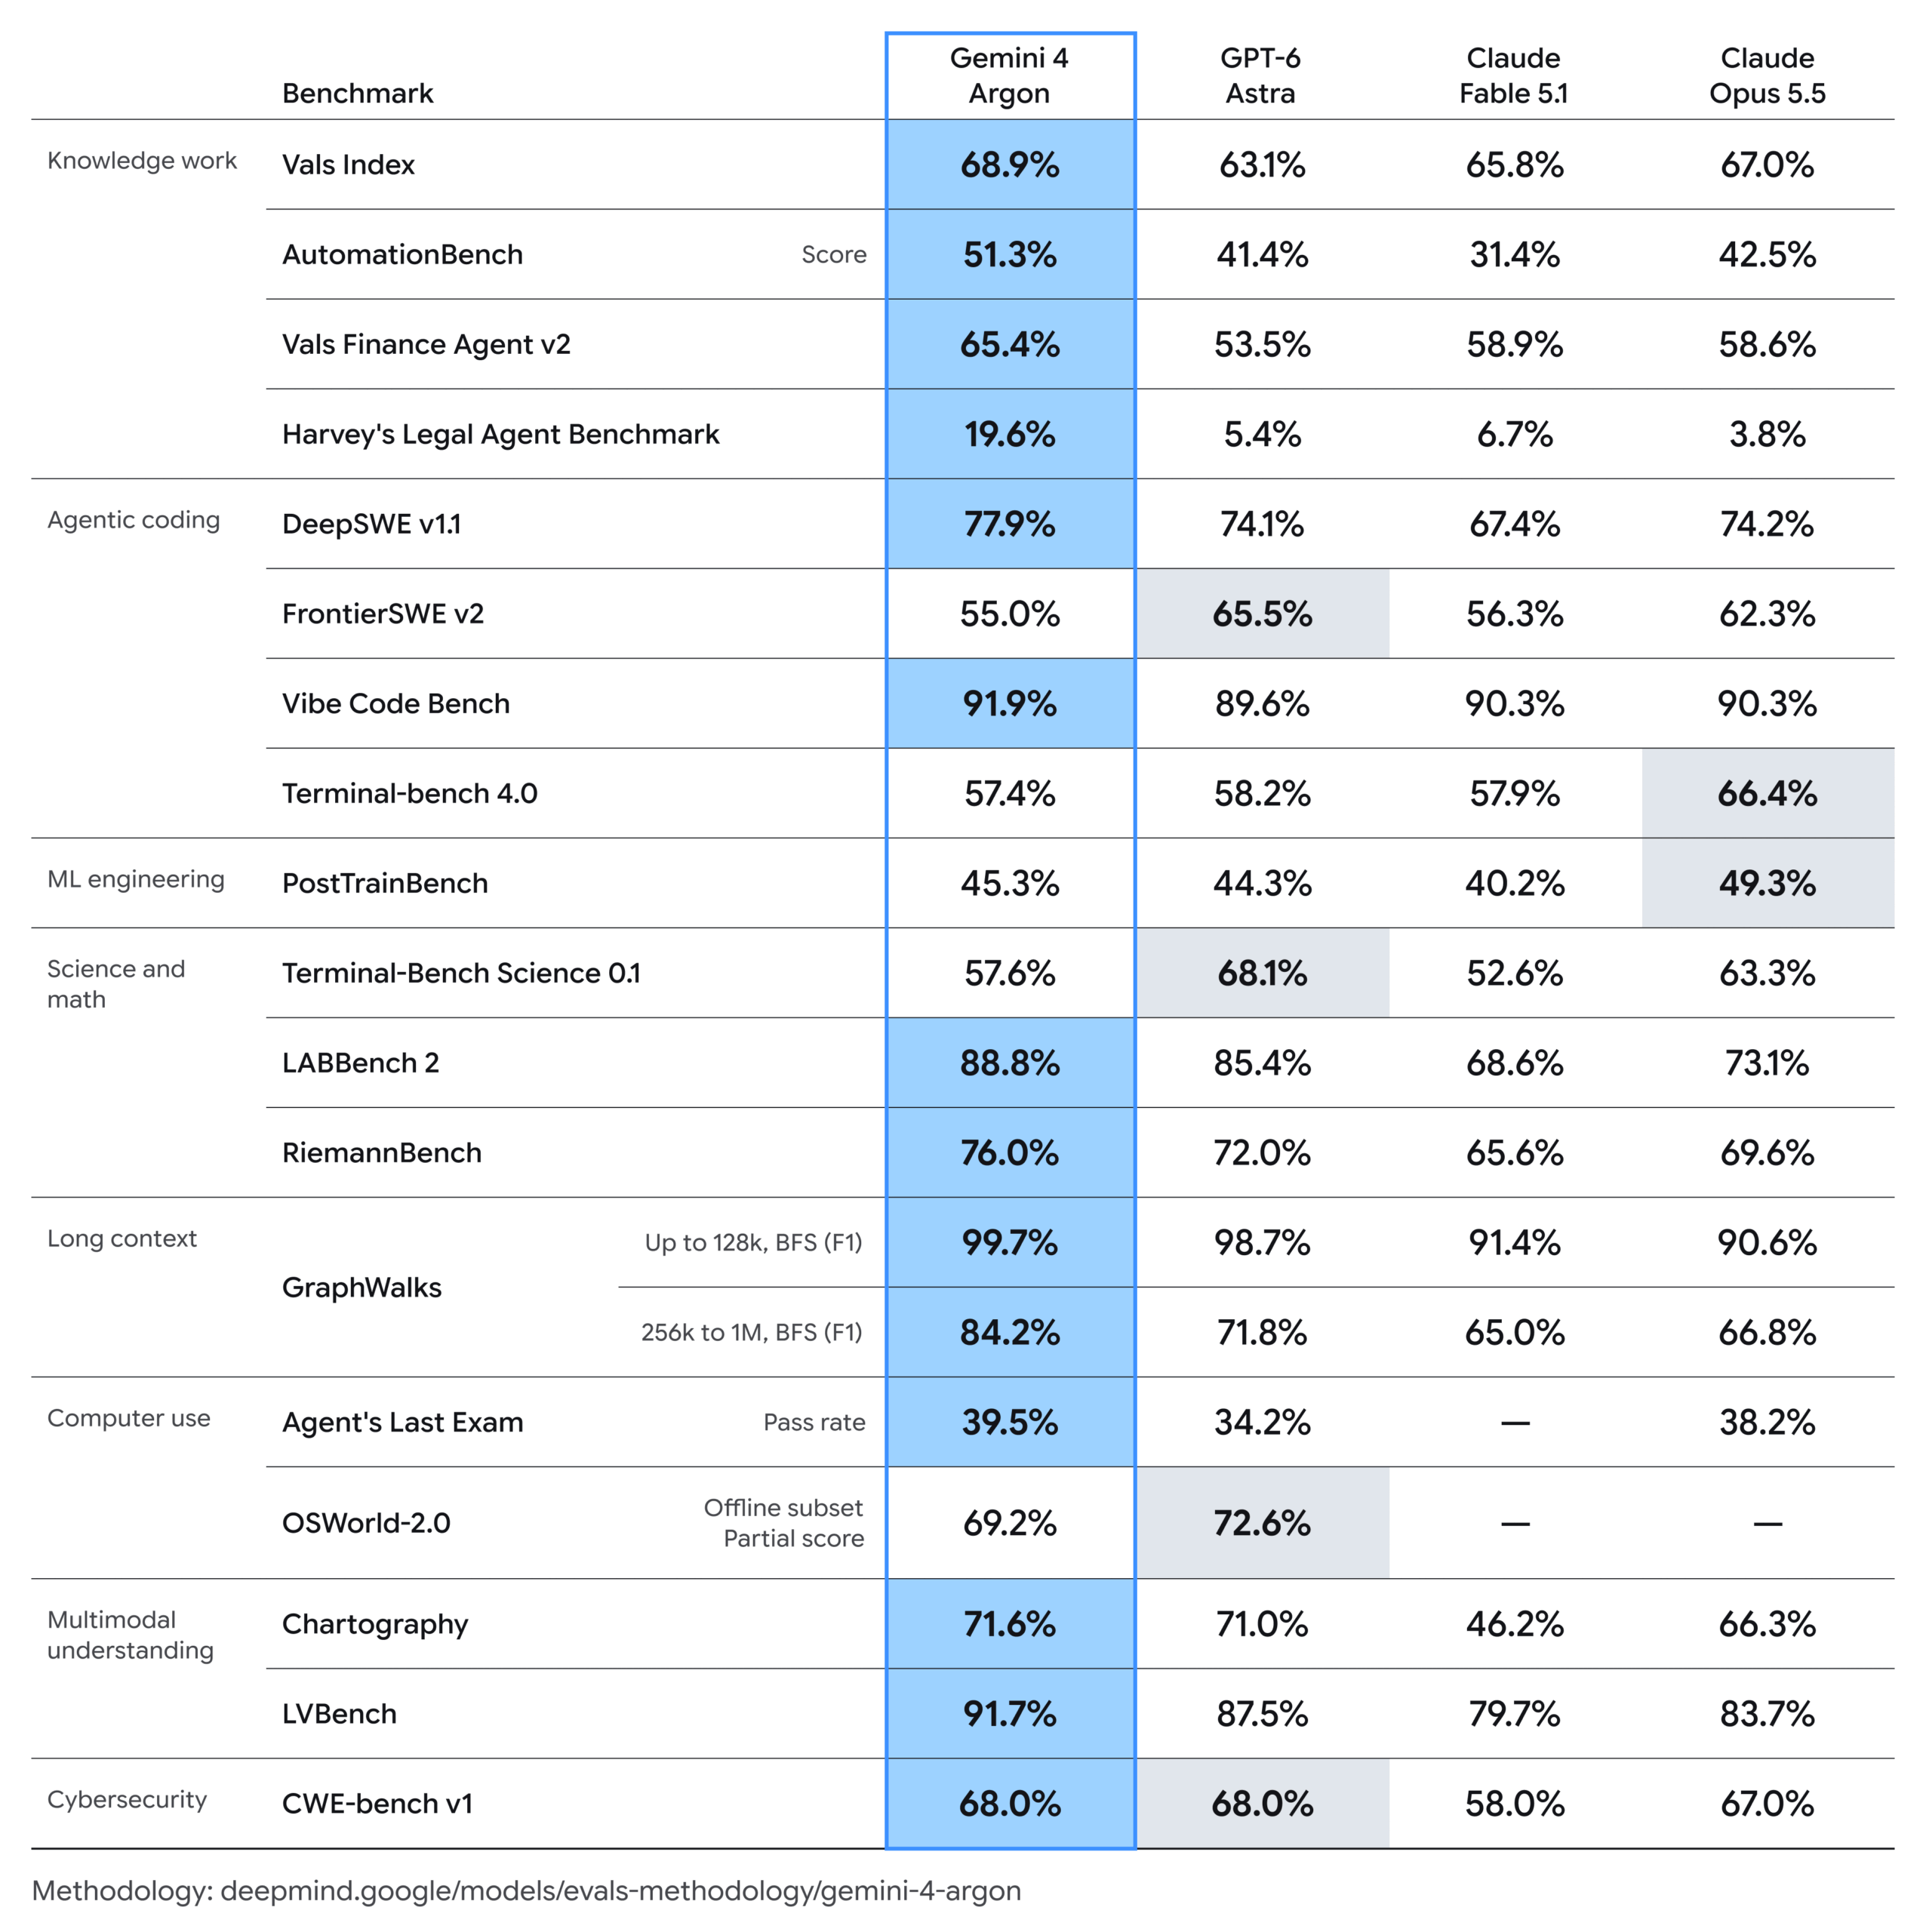
في الجدول لاحظ أن النتائج الأقوى تأتي في المعايير التي تقيس المهام الطويلة متعددة الخطوات، وهي النقطة التي تبني عليها Google روايتها كلها.
المثال الأوضح على القدرة الأمنية يأتي من Wiz، التي تستخدم Argon ضمن مبادرة Scan for Good. تحمي هذه المبادرة البنية التحتية العامة الحرجة مجاناً، عبر رصد نقاط الانكشاف عالية الخطورة ومعالجتها. في عرض مبكر، كشف النموذج ثغرة حرجة تعرّض بيانات شخصية حساسة للخطر في برمجيات رعاية صحية تستخدمها مستشفيات حول العالم، وكانت نماذج حدّية سابقة قد فاتتها، بحسب Google. الرواية تستند إلى مصدر وحيد هو إعلان Google نفسه، ولم تُنشر تفاصيل تقنية عن الثغرة أو الجهة المتأثرة.
أما الضمانات التي تقول Google إنها تعززها قبل الإتاحة الواسعة، فتتوزع على أربعة محاور. الأول منع إساءة الاستخدام في الهجمات السيبرانية أو الكيميائية أو البيولوجية أو الإشعاعية أو النووية (CBRN). يرفض النموذج الطلبات الضارة مع الإبقاء على البحث العلمي المشروع مزدوج الاستخدام، وفق إطار السلامة الحدّية لدى الشركة. وتعمل Google على تحسين تقنيات مراقبة التنشيطات الداخلية للنموذج لرصد الإساءة، وقد اختبرت فرق حمراء داخلية وخارجية هذه الضمانات بهجمات يدوية وآلية. المحور الثاني مقاومة حقن التعليمات غير المباشر (prompt injection)، أي تمرير تعليمات خبيثة عبر السياق لاختطاف سلوك النموذج. تصف Google النموذج بأنه الأكثر صلابة لديها هنا، ويتصدر معيار Gray Swan لحقن التعليمات غير المباشر بعد تدريب عدائي وفرق حمراء آلية.
المحور الثالث هو الأكثر إثارة للاهتمام: مراقبة سلسلة التفكير (chain-of-thought) وأفعال النموذج، وإيقاف التنفيذ إذا حاول تحقيق مهمة بطريقة تتجاوز نية المستخدم. استخدمت Google نظاماً مشابهاً أثناء التدريب، يرسل تنبيهات إلى فريق مخصص للاستجابة للحوادث. وتقول إنها امتنعت عن إعادة ما تكتشفه إلى بيانات التدريب، حتى لا يتعلم النموذج إخفاء تفكيره عن أدوات المراقبة. وتدعو الشركة بقية القطاع صراحة إلى الحفاظ على شفافية الاستدلال. المحور الرابع تحصين البيئات المعزولة (sandbox) بعزلها وإغلاقها قبل التدريب أو التقييم عالي الخطورة، وفق خارطة طريق Google للتحكم بالوكلاء، مع وعد بمشاركة هذه الممارسات مع الشركاء.
تقديرنا أن الرهان الحقيقي في هذا الإطلاق هو حد المخرجات لا الأرقام على المعايير. فالقفز من 64 ألفاً إلى مليون توكن يغيّر شكل الوكلاء التي تستطيع بناءها، وقد تصبح قادرة على إنجاز ترحيل كامل أو تقرير قانوني طويل في مسار واحد. لكن هذا يرفع أيضاً كلفة الاستدعاء الواحد عند 10 دولارات للمليون. القرار الأكثر جرأة هو إتاحة النموذج دون حواجز سيبرانية لفئة “موثوقة”. تعريف هذه الفئة وآليات محاسبتها غير منشورة بالتفصيل، وهذا يأتي بعد أسابيع من إلغاء OpenAI إطلاق GPT-6.1 Astra لإخفاقه أمنياً. وتبقى ملاحظة جوهرية: معظم النتائج مصدرها Google نفسها أو شركاء مثل Wiz وZapier وHarvey. وحتى يصل النموذج إلى أيدي مطورين مستقلين، فهي أرقام معلنة من الشركة نفسها وتحتاج إلى اختبار خارجي. هل ستنتظر أنت هذه الاختبارات، أم تكفيك أرقام Google لتخطط لاعتماده؟
المصادر
- Gemini 4 Argon: our next era of frontier intelligence blog.google
- Fairwind Program deepmind.google
- Vals Index Leaderboard and Methodology | Vals AI vals.ai