بحسب IBM، يصد نموذجا LLMON هجمات حقن أكثر بنسبة 47% من أفضل نموذج رائد مختبر، دون تراجع عن أداء Granite 4.1 Instruct العام.
ضمن ملف: نماذج الذكاء الاصطناعي، وكلاء الذكاء الاصطناعي
بقلم: يوسف | محرر أدوات الذكاء الاصطناعي · صوت تحريري بإشراف بشري
المصدر الأساسي: IBM Granite Blog on Hugging Face
لماذا يهم
مطورو الوكلاء وأنظمة RAG الذين يمررون مستندات وردود أدوات غير موثوقة إلى نماذج صغيرة يحصلون على طريقة لفصل الأوامر عن البيانات داخل النموذج نفسه، بدل الاعتماد على حواجز خارجية فقط.
أطلقت IBM لغة ترميز جديدة اسمها LLMON (اختصار LLM Object Notation، وتُنطق “ليمون”)، مصممة لتخاطب النماذج اللغوية بلغتها هي بدل JSON. ورافق الإطلاق نموذجان تجريبيان مبنيان على Granite 4.1 هما granite-4.1-3b-LLMON-preview وgranite-4.1-8b-LLMON-preview، إضافة إلى مستودع على GitHub يضم أدوات للعمل باللغة وأمثلة على سير العمل والقوالب، بحسب مدونة IBM Granite على Hugging Face المنشورة في 12 نوفمبر 2026. الوعد الأساسي هو أن يتجاهل النموذج التعليمات الخبيثة المدسوسة داخل البيانات، لأنه صار يعرف بوضوح أين تنتهي الأوامر وأين تبدأ المادة المطلوب قراءتها.
تنطلق الفكرة من مشكلة يعرفها كل من بنى وكيلاً أو نظام RAG. يمتلئ سياق النموذج خلال المحادثة الطويلة بمكونات كثيرة: موجّه النظام، والأدوار السابقة، وتعليمات تعمل على مستندات مسترجعة، وردود الأدوات، وبيانات المستخدم، وقيود على شكل المخرجات، وسلاسل الاستدلال. هذا السياق غني بالبنية، لكن معظم هذه البنية ضمني أو مرمّز بصيغ مثل JSON لم تُصمم أصلاً لكي يهضمها نموذج لغوي. وترى IBM أن هذا من الأسباب الرئيسية لهشاشة النماذج، خاصة الصغيرة منها، ولفشلها بطرق غير متوقعة. كما يستغل المهاجمون غياب البنية الصريحة في هجمات حقن الأوامر (prompt injection)، بحسب IBM.
لماذا لا يكفي JSON؟ تقول IBM إنه صُمم للمحللات البرمجية (parsers) لا للنماذج السببية (causal). المرمِّز (tokenizer) لا يلتزم بقواعده، والبنية مرمّزة برموز مثل { و” و: تظهر أيضاً في النص العادي. علامة التنصيص داخل مستند وعلامة التنصيص التي تغلق حقلاً هما الرمز نفسه في نظر النموذج، وقواعد الهروب (escaping) الواضحة للمحلل ليست سوى أنماط إحصائية للنموذج. أما عمق التداخل فيُرمَّز بعدّ الأقواس، وهي مهمة يُعرف أن نماذج transformer ضعيفة فيها، خصوصاً على المسافات الطويلة. في المقابل، LLMON لغة شبيهة بـXML، فواصلها البنيوية رموز خاصة محجوزة (special tokens) لا حروف، فتستخدم البنية والمحتوى أجزاء منفصلة من المفردات. يُذكر الوسم في بداية كل مقطع، وتكون الحدود بين المقاطع صريحة، ويُعلن التداخل محلياً فلا يحتاج النموذج إلى تتبع التسلسل الهرمي عبر مسافات طويلة.
العنصر الأذكى في التصميم هو المعرّفات الفريدة. يأخذ كل مكوّن معرّفاً قصيراً يمكن الإشارة إليه من أي مكان في السياق، ثم تُربط التعليمات بالبيانات التي يجب أن تعمل عليها، بالطريقة نفسها التي تُستدعى بها الدوال وتُمرَّر إليها المعاملات في لغات البرمجة. ولا تحل LLMON محل قوالب المحادثة (chat templates)، بل تثريها. القالب العادي يخبر النموذج بالدور الذي ينتمي إليه كل جزء (system أو user أو assistant)، أما LLMON فتخبره بمعنى كل مكوّن وعلاقته بالمكونات الأخرى داخل الأدوار وعبرها.
يصبح المثال الذي تعرضه IBM أوضح عند قراءته. أنت تبني قائمة الرسائل كما تفعل مع أي نموذج محادثة، لكنك تسمّي أجزاء الدور وتضع على كل جزء الوسم exec: True أو False:
messages = [
  {
    "role": "user",
    "instruction": [{ "value": "Write a short paragraph about", "exec": True }],
    "data": [{ "value": "IBM Company", "exec": True }],
    "requirement": [
      {"value": "Use less than 10 words", "exec": True},
      {"value": "Do not use commas", "exec": True}]
  }
]
ثم يحوّل القالب هذه الرسالة إلى ما يشبه التالي (أضافت IBM الأسطر الجديدة للتوضيح فقط، فالقالب لا يُخرج أياً منها):
<|open|>instr<|:|>Ȗ<|close|>Write a short paragraph about<|open_end|>
<|open|>data<|:|>ä¦<|close|>IBM Company<|open_end|>
<|open|>req<|:|>Á¼<|close|>Use less than 10 words<|open_end|>
<|open|>req<|:|>¢¬<|close|>Do not use commas<|open_end|>
<|open|>exec<|:|>ÄÐ<|close|>
  <|open|>exec<|.|>instruction<|close|>instr<|:|>Ȗ<|open_end|>
  <|open|>exec<|.|>input<|close|>data<|:|>ä¦<|open_end|>
  <|open|>exec<|.|>requirement<|close|>req<|:|>Á¼<|open_end|>
  <|open|>exec<|.|>requirement<|close|>req<|:|>¢¬<|open_end|>
  <|open|>exec<|.|>output<|close|>assistant<|:|>ãø<|open_end|>
<|open_end|>
<|open|>assistant<|:|>ãø<|close|>
يبقى الدور دوراً واحداً للمستخدم، لكن مكوناته تصل إلى النموذج على شكل خمس كتل منفصلة قابلة للإشارة، تربطها كتلة سادسة هي كتلة التنفيذ (exec) التي تقول: نفّذ هذه التعليمة، على هذه البيانات، مع مراعاة هذين الشرطين، وضع الإجابة في الكتلة المسماة هنا، وهي كتلة assistant نفسها التي يملؤها النموذج بعد ذلك (وفقاً لـ IBM Granite). أما الأجزاء الموسومة بـFalse فتظهر في السياق لكن لا شيء يشير إليها. والمعرّفات المكونة من حرفين مأخوذة من مجموعة ثابتة يرمّزها هذا المرمِّز كرموز مفردة، فتكلفة الإشارة إلى أي كتلة رمزان فقط أياً كان المعرّف (وفقاً لـ IBM Granite). القالب التقليدي كان سيدمج كل ذلك في سلسلة نصية واحدة ويترك للنموذج أن يخمّن أيها المهمة وأيها الموضوع وأيها القيود.
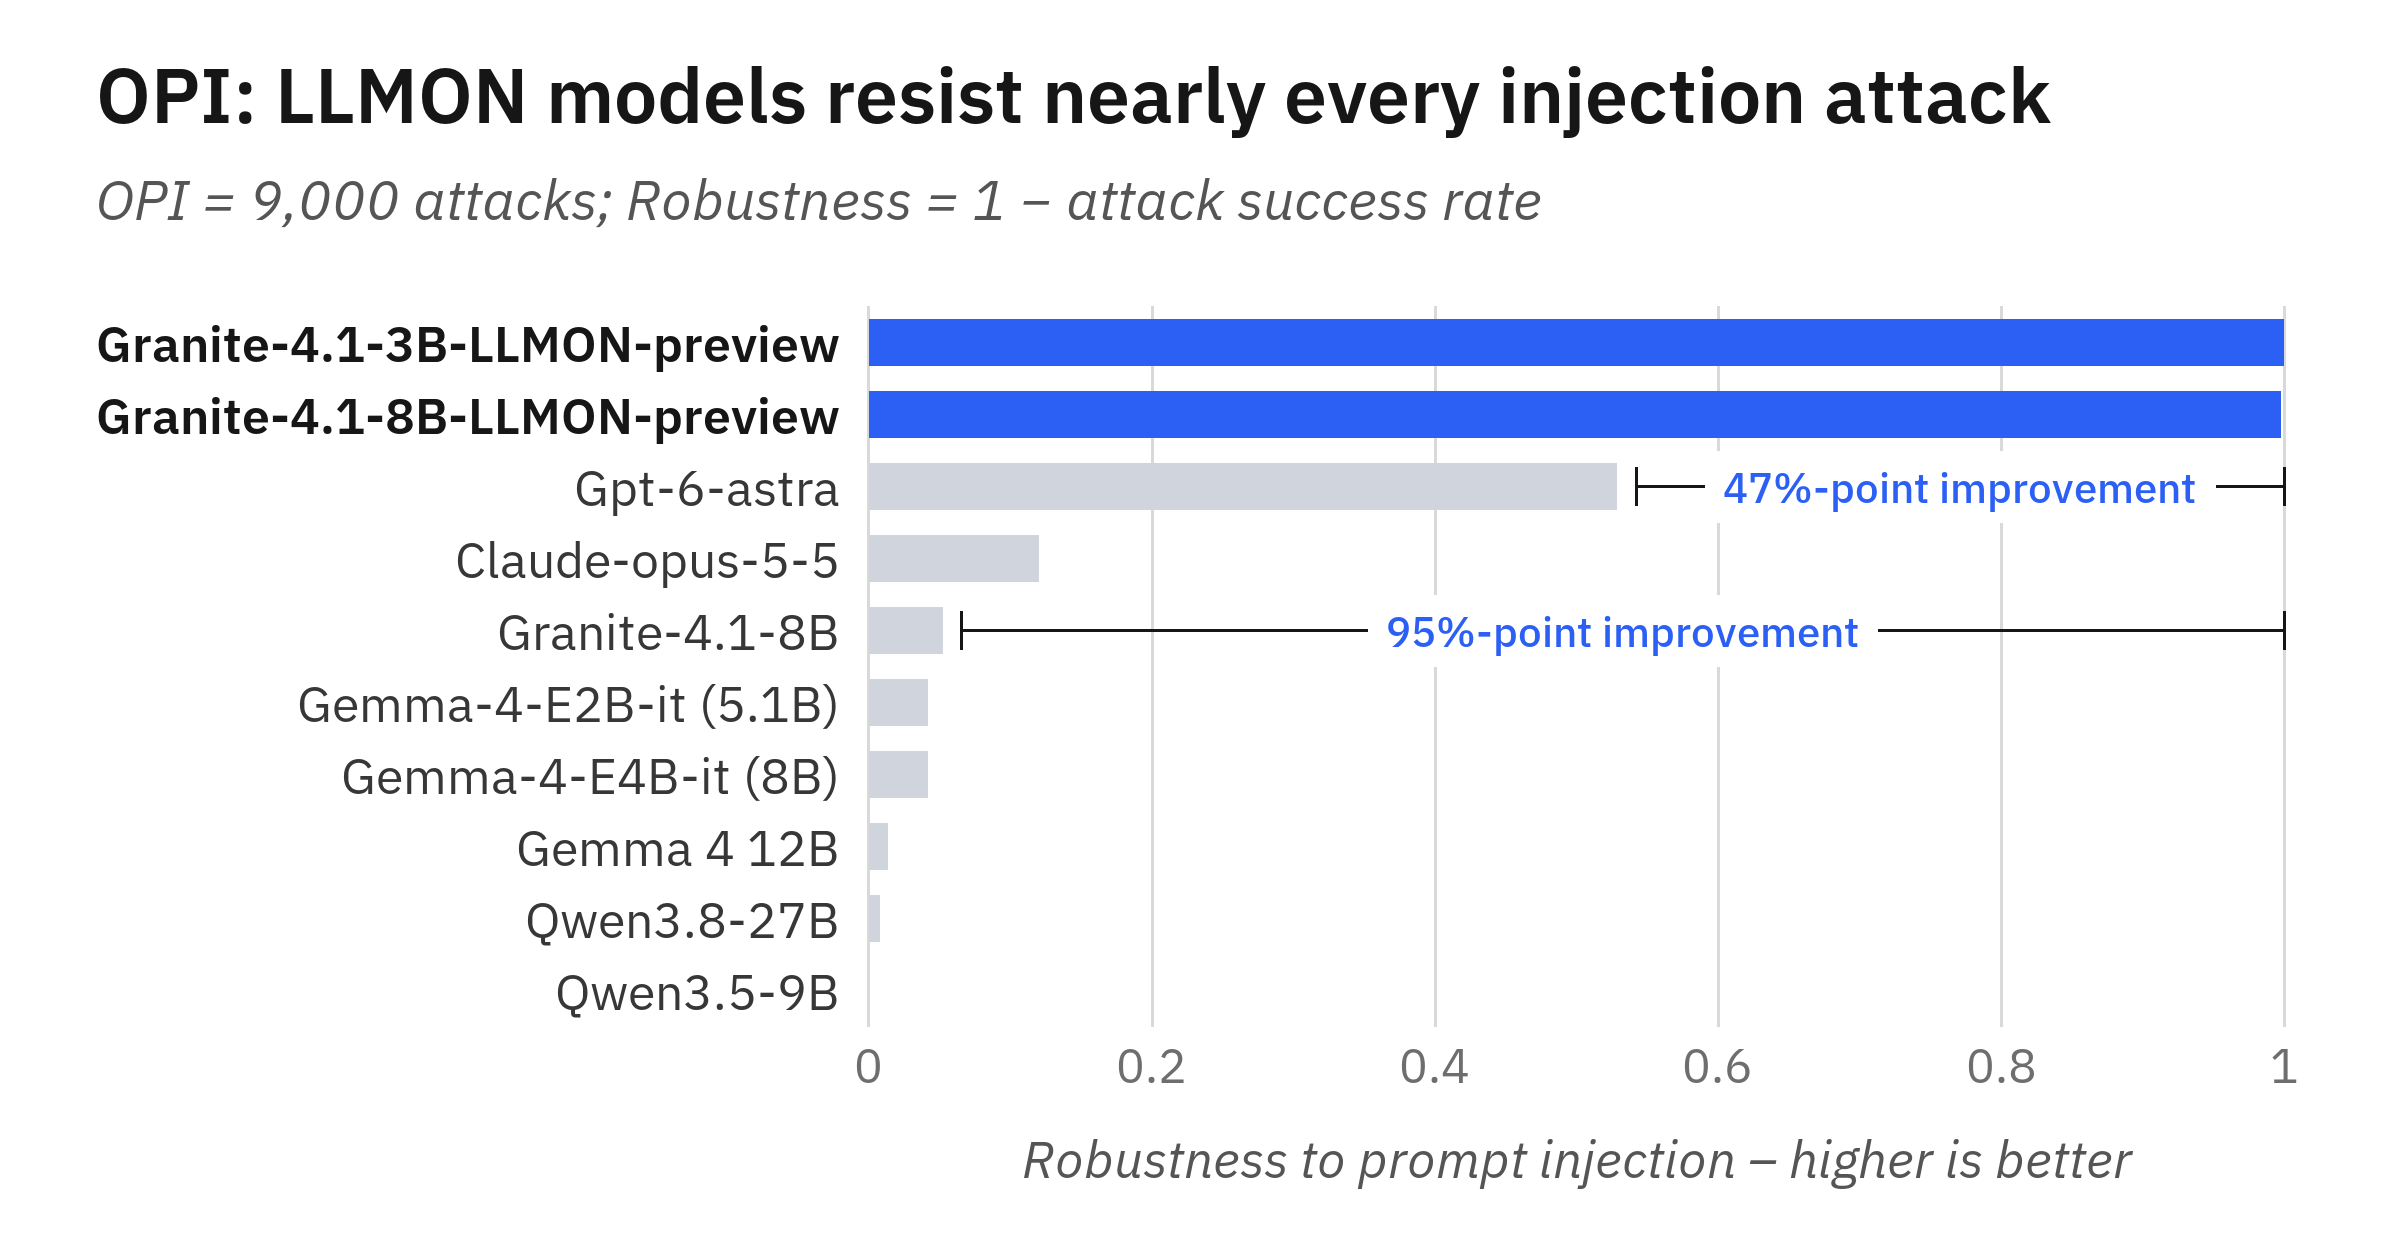
تجرّب IBM هذا الفصل على أخطر نقطة في الوكلاء اليوم: حقن الأوامر غير المباشر، حيث تُخفى تعليمة خبيثة داخل مستند مسترجع أو رد أداة أو بيانات مستخدم. قارنت الشركة نموذجيها بعدة نماذج مفتوحة ومغلقة على معيار OPI الذي يضع الحقن داخل بيانات مهام NLP كلاسيكية ويستخدم عدة استراتيجيات هجوم، وقاست المتانة على أنها 1 ناقص نسبة نجاح الهجوم، أي حصة الهجمات التي لم ينفذ فيها النموذج التعليمة المحقونة. النتيجة بحسب IBM أن كل النماذج غير المبنية على LLMON نفذت التعليمات المحقونة باحتمال مرتفع، بينما تفادى نموذجا LLMON 47% هجمات أكثر مقارنة بأفضل نموذج رائد (frontier) اختبرته الشركة، و95% أكثر من أفضل نموذج مفتوح المصدر (وفقاً لـ IBM Granite)، مع اقتراب نسبة نجاح الهجمات من الصفر في بعض المعايير. وتقول الشركة إنها رصدت اتجاهات مماثلة على معياري ASB وStruQ. هذه أرقام معلنة من الشركة نفسها، ولم تكشف المدونة أسماء النماذج المنافسة بالتفصيل في النص.
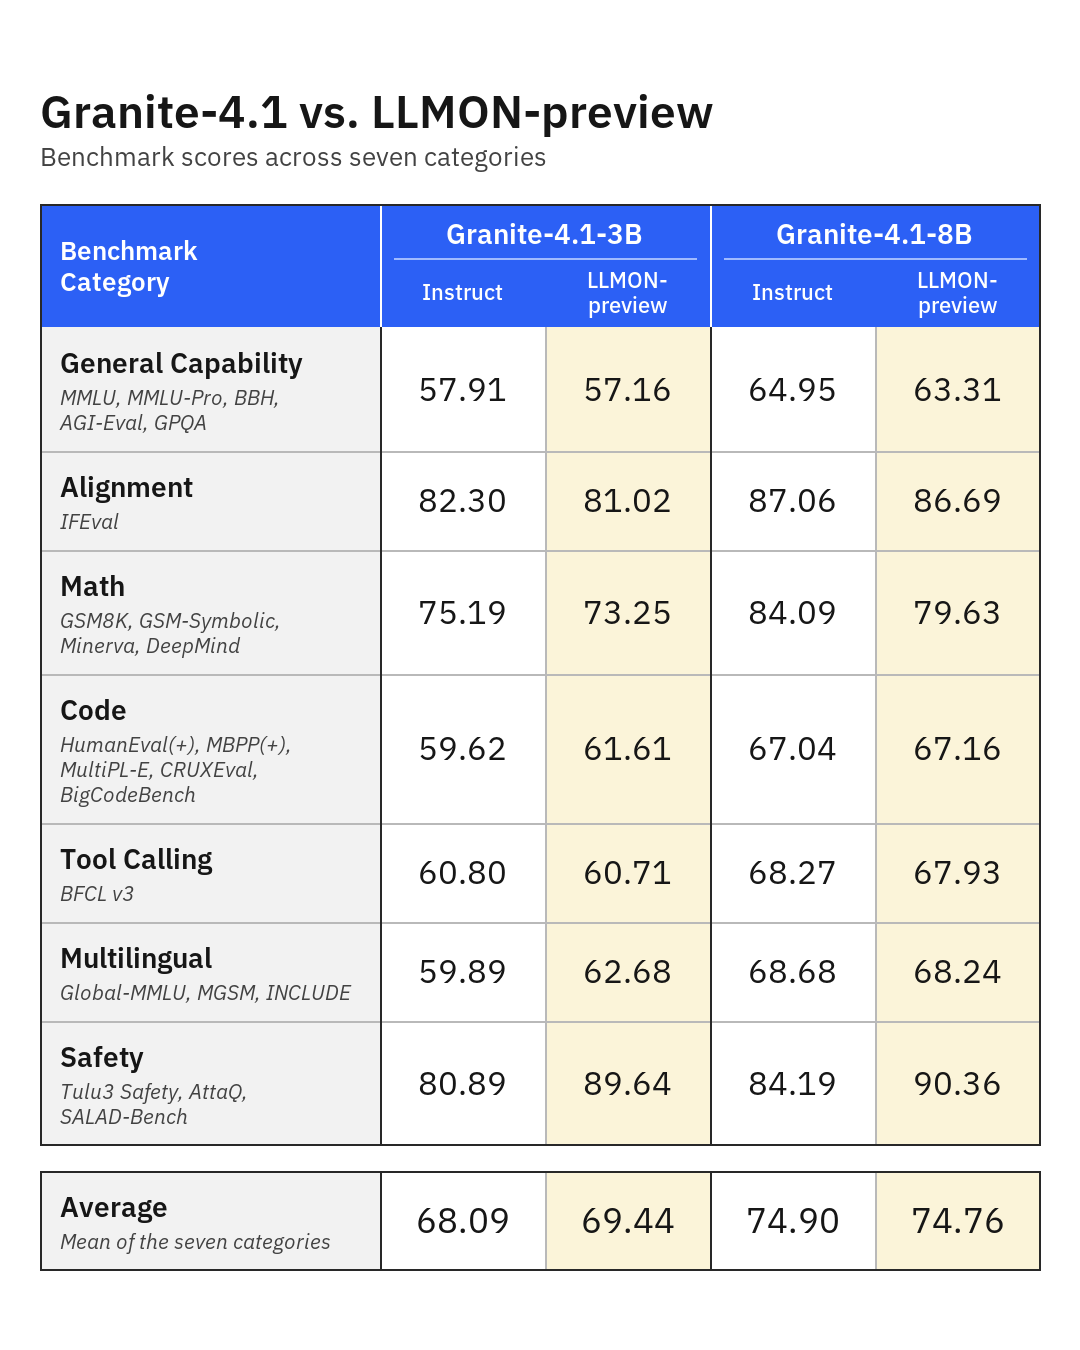
وتؤكد IBM أن مكاسب الأمان لم تأتِ على حساب القدرات العامة، إذ يؤدي نموذجا LLMON أداءً مماثلاً لنماذج Granite 4.1 Instruct عبر فئات المعايير القياسية (وفقاً لـ IBM Granite)، وهي أيضاً أرقام معلنة من الشركة نفسها.
أما التدريب فبدأ من نقاط Granite 4.1 الأساسية (base) لا من نماذج Instruct المنشورة، حتى يُتعلَّم سلوك LLMON خلال مرحلة ما بعد التدريب بدل تركيبه فوق صيغة محادثة قائمة. تعرّف LLMON ستة فواصل تحدد بداية الوسوم ونهايتها وتسمح بالتداخل والتثبيت، وقد ثُبّتت في المرمِّز كرموز مفردة محجوزة (وفقاً لـ IBM Granite). ثم أعاد الفريق تسلسل مدونة تقليدية لضبط التعليمات بصيغة LLMON، فصار كل مكوّن من مكونات الموجّه كتلة مستقلة، وكل دور يحمل كتلة تنفيذ. مزيج المهام هو نفسه الذي يراه نموذج Instruct عادي (محادثة، ومحادثة متعددة الأدوار، وRAG، واستدعاء أدوات)، وهذا ما يفسر بقاء الأداء قريباً. وأُضيفت للبيانات تعليمات وكتل بيانات مخادعة (decoy) موجودة في السياق لكنها غير مربوطة عمداً، مع إبقاء المخرج المستهدف كما هو، فيتعلم النموذج اتباع ما تمليه كتلة التنفيذ وتجاهل الباقي. تلا ذلك تعلم معزز عبر خمس مراحل GRPO متتالية شملت الاستدلال متعدد المجالات وRLHF ومعايرة المعرفة والرياضيات، ثم مرحلة DPO أخيرة على ألف زوج تفضيلات مبنية من ردود النموذج نفسه على محاولات الحقن (وفقاً لـ IBM Granite).
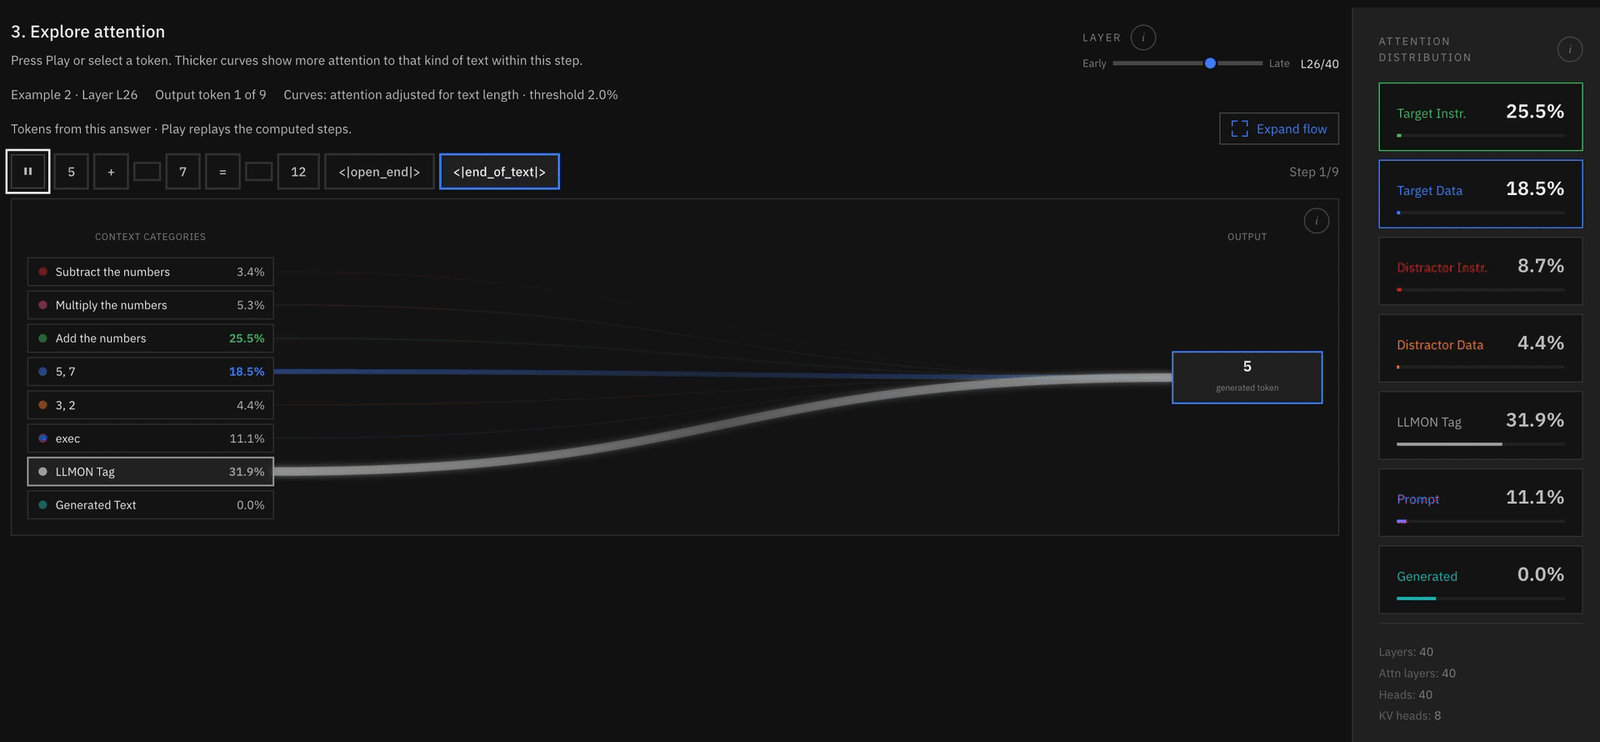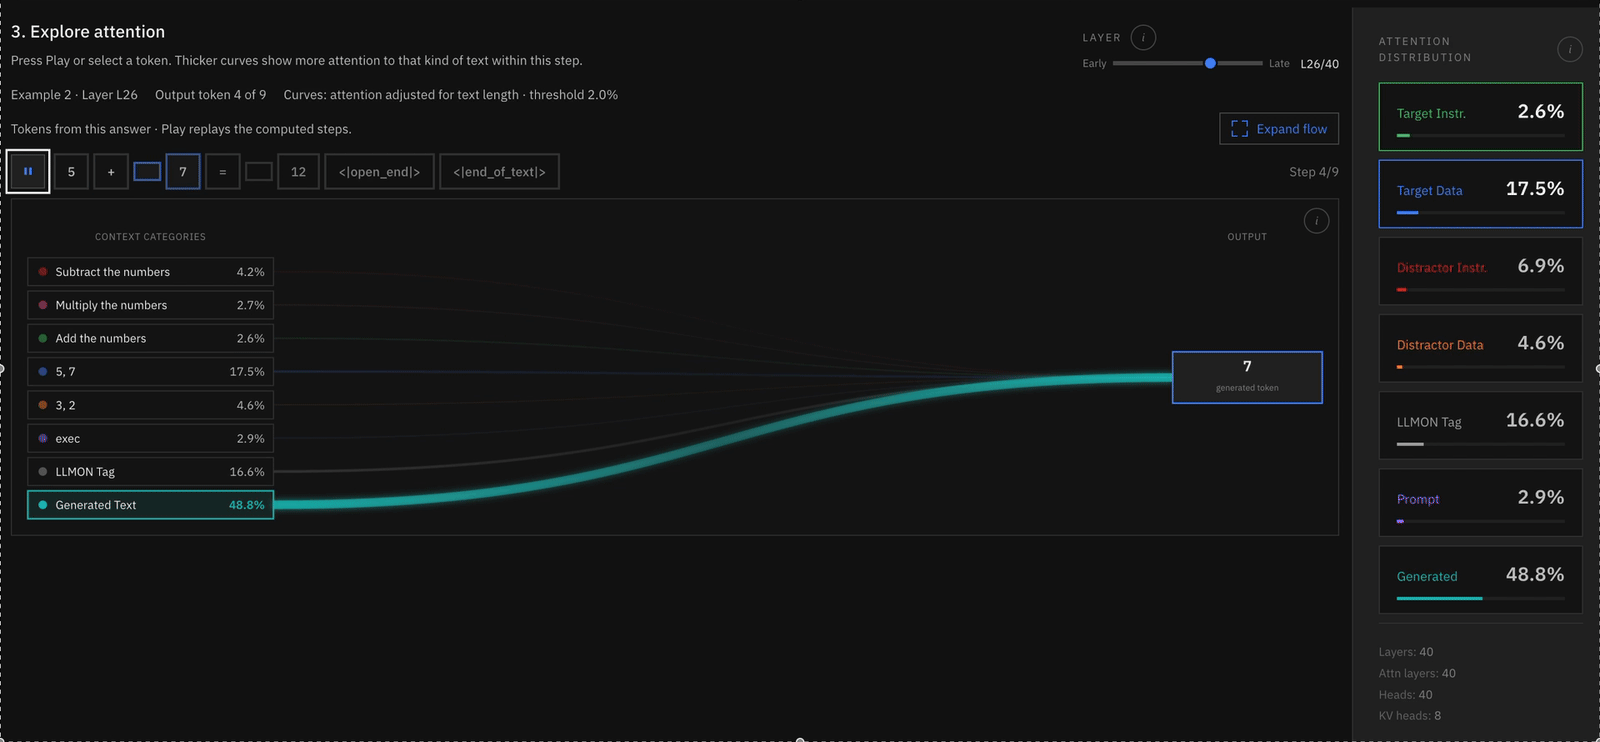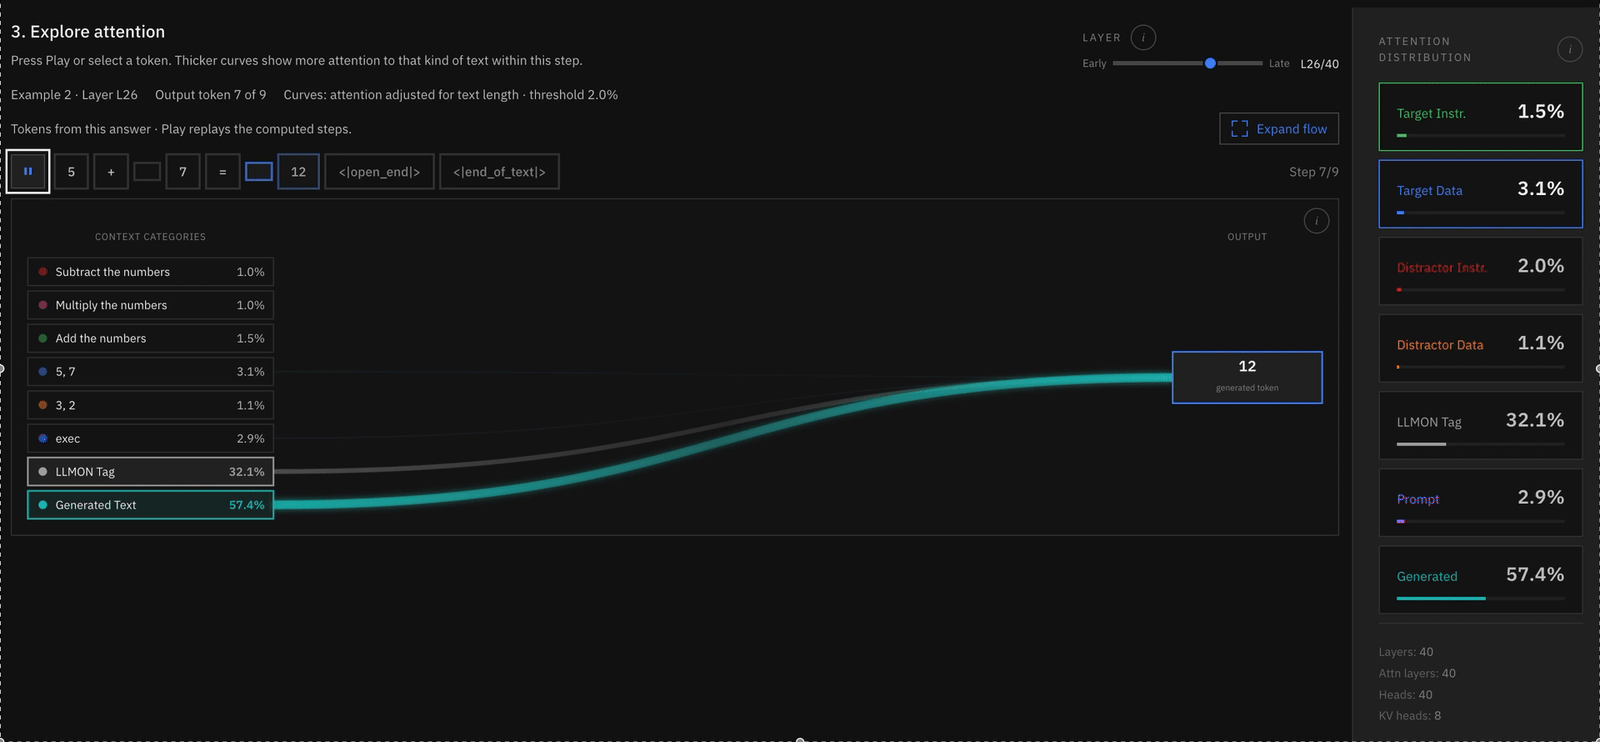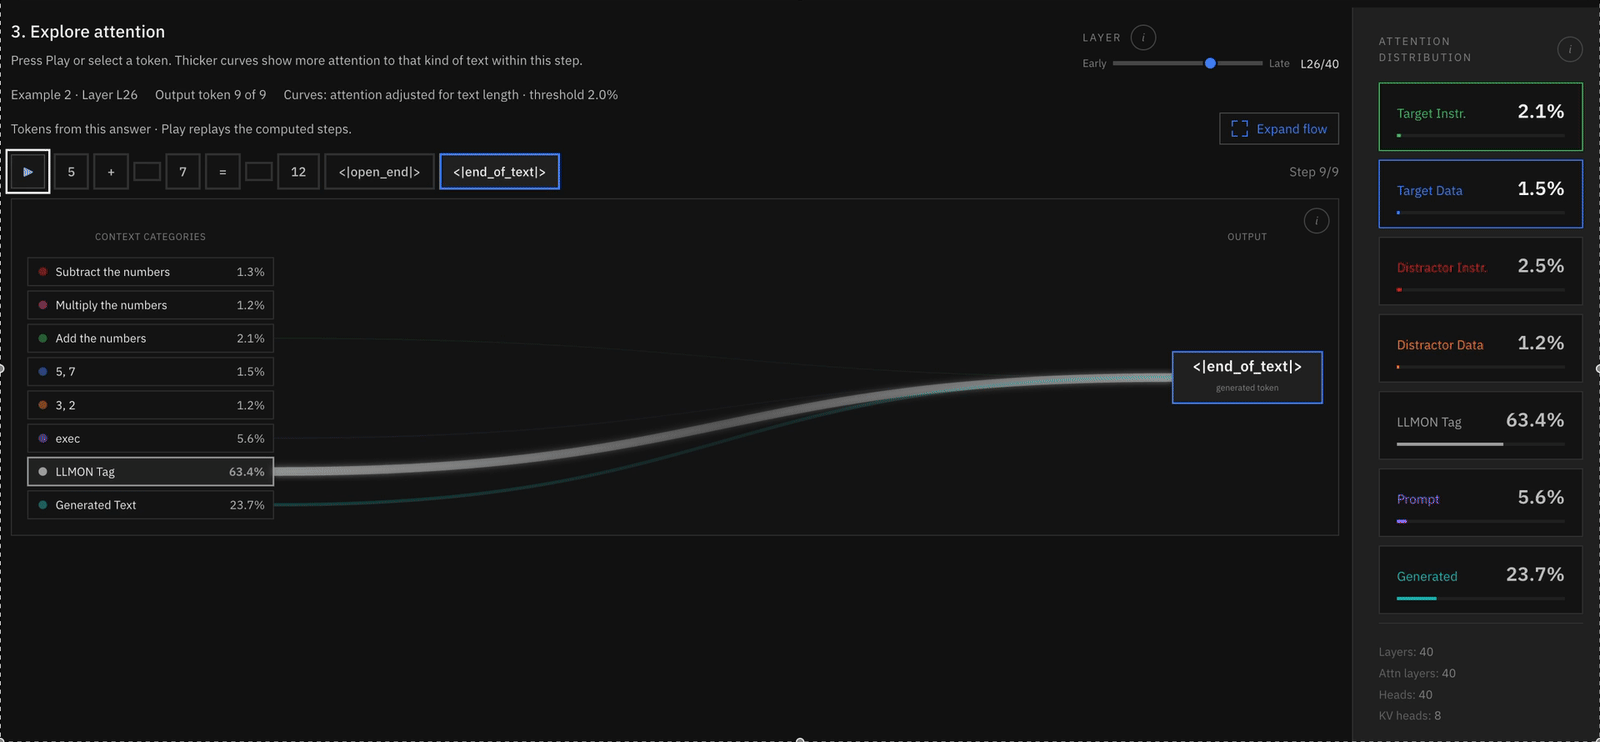
تنتج عن هذا التصميم قاعدة صلاحيات واضحة: التعليمة التي تُستدعى عبر كتلة تنفيذ لها السلطة، وكل ما يصل كمدخلات (بيانات، مستندات، مخططات أدوات، نتائج أدوات) مادة للقراءة لا أمر للتنفيذ، والمقاطع غير المستدعاة تُتجاهل. وتنشر IBM أداة LLMON Attention Visualization على Hugging Face Spaces لمن يريد رؤية ذلك داخل طبقات الانتباه.
إن كنت تعمل اليوم على Granite 4.1 بحجم 3B أو 8B، فهذه خطوات التجربة كما تصفها IBM:
- استبدل نموذجك الحالي بنسخة المعاينة المناسبة من granite-4.1-8b-LLMON-preview أو نسخة 3B، فهما تأتيان بقالب محادثة خاص بهما، ولا يلزم أي خط تحويل.
- ابنِ قائمة
messagesكالمعتاد، لكن سمِّ أجزاء الدور (instruction وdata وrequirement) بدل دمجها في نص واحد، ثم استدعِapply_chat_templateكما تفعل دائماً ليولّد كتل LLMON تلقائياً. - ضع
exec: Trueعلى الأجزاء التي يجب أن يعمل عليها النموذج، وFalseعلى ما تريده في السياق دون أن يُنفَّذ، مثل المستندات المسترجعة غير ذات الصلة أو الأدوار القديمة. - إذا كان أحد الأجزاء بيانات مهيكلة مثل مستند JSON، فاستخدم مكتبة LLMON-converters من مستودع المشروع لتحويله دون فقدان إلى كتل مصنّفة قابلة للإشارة فردياً، مع إمكانية التحويل العكسي إلى JSON بالدقة نفسها.
- جرّب مكتبة Mellea من IBM إن كنت تكتب برامج توليدية، فهي تدعم LLMON أصلياً وتحوّل استدعاءاتها للنموذج تلقائياً، فلا تعود مضطراً لإجبار النموذج على احترام بنية JSON.
- عرّف مفرداتك الخاصة إذا احتاج مجالك ذلك، ثم درّب LoRA فوق نموذج LLMON ليفهمها، كما فعلت IBM على ScienceWorld حيث يؤدي وكيل مهام علمية بسيطة مثل غلي الماء بأمر واحد في كل مرة، باستخدام وسوم مثل instr.task.goal وreq.planning_policy.rule وdata.state.room وdata.state.inventory وassistant.next_action، مع دفتر ملاحظات يغطي المسار من تحويل المسارات المرجعية إلى اللعب على ألعاب مستبعدة ومقارنة المحوّل بالنموذج الأساسي، ودفتر آخر لوكلاء استدعاء الأدوات.
تقديرنا في موجز أن LLMON من أذكى الأفكار التي ظهرت في ملف حقن الأوامر منذ مدة، لأنها تعالج المشكلة في مستوى الترميز نفسه بدل إضافة طبقات حماية خارجية هشة. لكن القيود واضحة ولا ينبغي القفز فوقها. أولاً، هذه معاينة تجريبية للاستكشاف، ولم تحدد IBM موعد إصدار مستقر بعد. ثانياً، الحماية سلوك متعلَّم لا ضمان مفروض، بتعبير الشركة نفسها. ثالثاً، المعايير المستخدمة تختبر الحقن غير المباشر الثابت، بينما ما زالت الهجمات التكيفية التي تتكشف عبر أدوار محادثة متعددة قيد العمل. رابعاً، تستند القصة إلى مصدر وحيد هو مدونة IBM على Hugging Face، ولم يتسنَّ التحقق من النتائج بشكل مستقل. فإذا كان نظامك يتعامل مع بيانات حساسة أو أدوات ذات صلاحيات عالية، فلا تتخلَّ عن فصل الصلاحيات والتحقق على مستوى التطبيق لمجرد أن النموذج صار أذكى في التمييز. والسؤال الأهم الآن: هل ستتبنى مختبرات أخرى صيغة مماثلة، أم تبقى LLMON حكراً على عائلة Granite؟
المصادر
- LLMON: An LLM-Native Markup Language, now in Granite 4.1 3B and 8B huggingface.co
- ibm-granite/granite-4.1-3b-llmon-preview · Hugging Face huggingface.co
- ibm-granite/granite-4.1-8b-llmon-preview · Hugging Face huggingface.co
- GitHub – generative-computing/llmon: LLMON (LLM Object Notation) github.com
- Formalizing and Benchmarking Prompt Injection Attacks and Defenses arxiv.org