من 370 ألف ساعة إلى 1.1 مليون: YODAS v3 تضاعف البيانات ثلاث مرات وتضاعف التردد بالحجم نفسه، 60 تيرابايت
ضمن ملف: إنفيديا، نماذج الذكاء الاصطناعي
بقلم: سارة | محررة نماذج الذكاء الاصطناعي · صوت تحريري بإشراف بشري
المصدر الأساسي: Hugging Face Blog (ESPnet)
لماذا يهم
يستطيع الباحثون والشركات الناشئة في مجال الصوت الآن تدريب نماذج تعرّف على الكلام وتوليد صوت بمستوى Whisper على بيانات مفتوحة قابلة للاستخدام التجاري، بدل الاعتماد على نماذج مغلقة.
أعلن فريق ESPnet إطلاق YODAS v3، وهي مجموعة بيانات كلام متعددة اللغات حجمها 1.1 مليون ساعة تغطي أكثر من 100 لغة (وفقاً لـ مدونة ESPnet على Hugging Face). وبحسب الإعلان المنشور في 27 سبتمبر 2026، فهي أكبر إصدار مفتوح في عائلة YODAS حتى الآن، وتبلغ نحو ثلاثة أضعاف النسخة الأولى. الإعلان موقّع من الباحثين William Chen وShinnosuke Takamichi وSayaka Shiota وSatoru Fukayama وShinji Watanabe. وتنبغي الإشارة إلى أن كل الأرقام الواردة هنا مصدرها مصدر وحيد هو الفريق نفسه، فهي أرقام معلنة من الفريق نفسه ولم يتسنَّ التحقق منها بشكل مستقل.
تتضح أهمية الخبر عند مقارنته بما كان متاحاً قبل ثلاث سنوات. يرى الفريق أن البيانات هي من يصنع الفارق الحقيقي في أبحاث الذكاء الاصطناعي، وأن أنظمة الصوت الرائدة مثل Whisper وGPT-Live من OpenAI بُنيت على مجموعات صوتية ضخمة ومغلقة. أما المجتمع المفتوح فقد اعتمد على موارد محدودة. قدّمت LibriLight نحو 60,000 ساعة من الإنجليزية غير المفرّغة نصياً (وفقاً لـ ESPnet)، ووسّعت Multilingual LibriSpeech الوصفة نفسها إلى 8 لغات (وفقاً لـ ESPnet). غير أن المجموعتين مأخوذتان من كتب صوتية مقروءة، وهو كلام نظيف ومتأنٍّ لا يشبه الحديث اليومي. وجاءت VoxPopuli بتغطية متعددة اللغات من تسجيلات البرلمان الأوروبي، لكن جزءاً صغيراً منها فقط كان مفرّغاً نصياً، ومحتواها خطابات سياسية رسمية بلغات أوروبية. واقتربت The People’s Speech من الصوت الطبيعي بنحو 30,000 ساعة (وفقاً لـ ESPnet)، إلا أنها إنجليزية فقط.
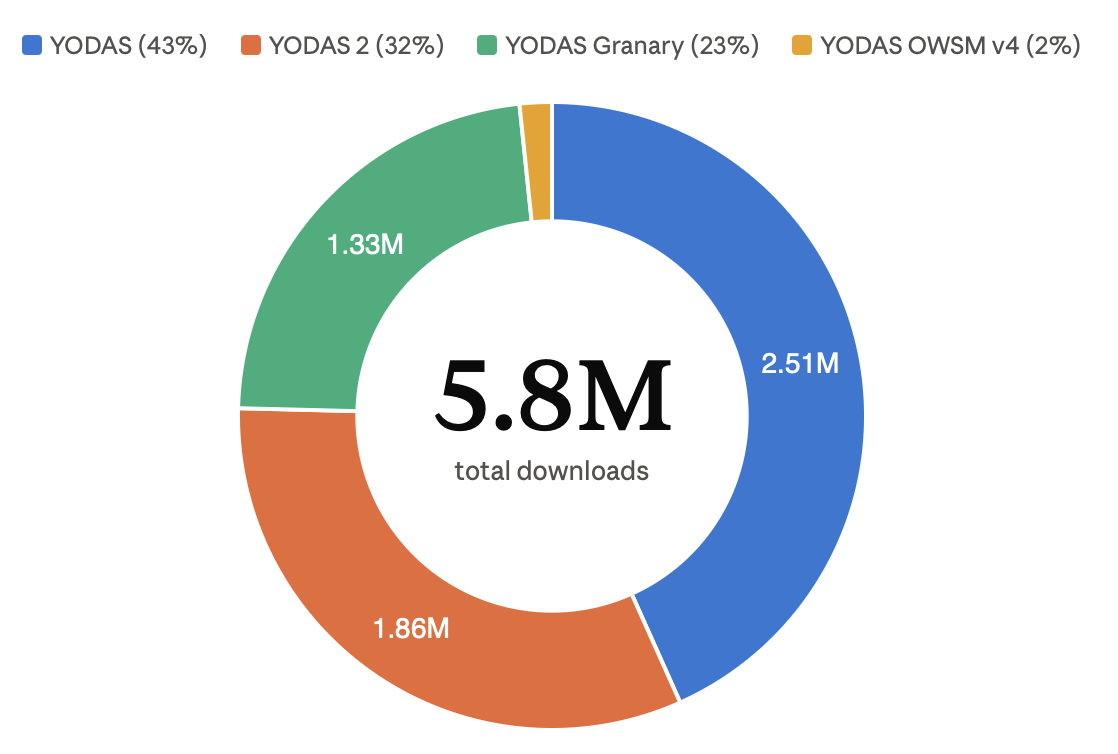
لسدّ هذه الفجوة صدرت النسخة الأولى من YODAS بنحو 370,000 ساعة من الكلام الواقعي القابل للاستخدام التجاري في أكثر من 100 لغة (وفقاً لـ ESPnet). ويقول الفريق إنها حُمّلت أكثر من 2.5 مليون مرة، ويرتفع الرقم إلى أكثر من 5.8 مليون عند احتساب المجموعات المشتقة الرسمية مثل YODAS 2 وYODAS Granary (أرقام معلنة من الفريق نفسه، وفقاً لـ ESPnet). ودخلت YODAS في تكوين مجموعات بيانات معروفة مثل Emilia وMOSEL وLEMAS، واستُخدمت في تطوير نماذج أساس إنتاجية منها IBM Granite وCanary وParakeet من NVIDIA وOLMoASR من AI2. كما كانت مصدراً رئيسياً لنماذج ومعايير إقليمية، منها Sea-LLMs وSEA-SpeechBench في جنوب شرق آسيا، وTyphoon 2 في تايلاند، وGigaAM وGigaChat Audio في آسيا الوسطى.
وبحسب الإعلان، تحسّن النسخة الثالثة كل البُعد تقريباً مما يهم في تدريب نماذج الصوت الحديثة. وهذه أبرز خمس نقاط فيها:
- الحجم والتغطية: 1.1 مليون ساعة مقابل نحو 370 ألفاً في النسخة الأولى، تغطي أكثر من 100 لغة، منها 34 لغة تتجاوز كل منها 1,000 ساعة (وفقاً لـ ESPnet). ويعدّ الفريق عتبة الألف ساعة الحد التقريبي الذي تكفي عنده بيانات اللغة لتدريب نموذج ASR قوي مستقل.
- دقة صوت عالية: البيانات كلها منشورة بتردد 48 كيلوهرتز. ولأن كثيراً من صوت الويب مرفوع التردد اصطناعياً من مصادر أضعف، قدّر الفريق التردد الفعلي لكل تسجيل من محتواه الترددي الحقيقي بدلاً من الاعتماد على ترويسة الملف. ووفق هذا التقدير، يبلغ أكثر من 92% من البيانات تردداً فعلياً يعادل 32 كيلوهرتز أو أعلى، ويبلغ 67% منها 44 كيلوهرتز (وفقاً لـ ESPnet). والتقدير متاح كبيانات وصفية، فيمكنك تصفية التسجيلات حسب الجودة التي تحتاجها مهمتك.
- قنوات متعددة حقيقية: أكثر من 70% من البيانات يحتوي على قناتين متمايزتين على الأقل (وفقاً لـ ESPnet). ولم يُحتسب التسجيل متعدد القنوات إلا إذا كانت قنواته مختلفة بشكل قابل للقياس، أما الصوت الأحادي المكرر والمخزّن كستيريو فصُنّف أحادياً. ويقول الفريق إنها المرة الأولى التي يمكن فيها تدريب نماذج توليد الصوت المجسّم والمكاني على نطاق واسع ببيانات مفتوحة.
- تفريغ نصي جاهز للاستخدام: يضم كل مثال الصوت بتردد 48 كيلوهرتز، والتفريغ النصي بطوابع زمنية على مستوى الكلمة والجملة، واللغة المكتشفة. ويتوفر حيثما أمكن ترجمة إنجليزية مزودة بتوقيتات، وهي تغطي أكثر من نصف البيانات متعددة اللغات (وفقاً لـ ESPnet). والبيانات منظمة حسب اللغة.
- حجم تخزين أخف: تشغل المجموعة 60 تيرابايت بصيغة OPUS، وهو الحجم نفسه الذي شغلته YODAS v2، لكنها تحمل ثلاثة أضعاف البيانات وضعف تردد العيّنة إضافة إلى القنوات الصوتية (وفقاً لـ ESPnet). والترخيص كما في النسخ السابقة هو CC BY 3.0، والتنزيل والمعاينة متاحان مباشرة على Hugging Face تحت اسم espnet/yodas3.
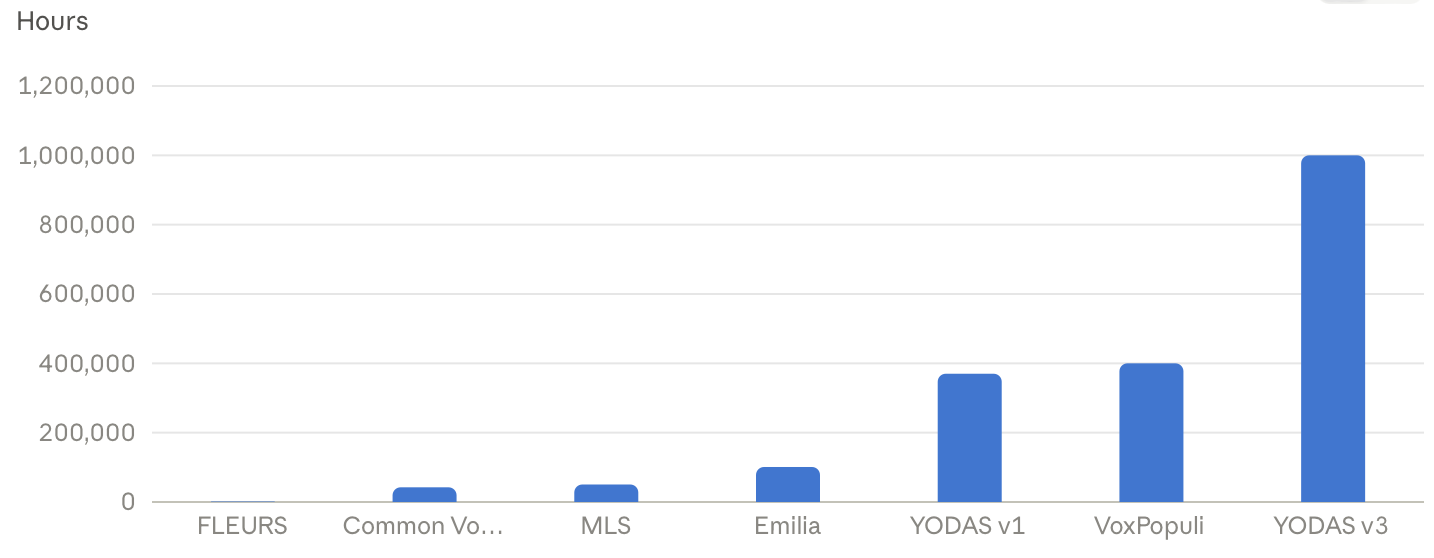
التحول الأعمق في رأينا ليس الحجم وحده، بل انتقال المجموعة من مورد مخصص للتعرف على الكلام إلى مادة خام لطيف أوسع من المهام. يقول الفريق إن 1.1 مليون ساعة تكفي أي جهة لتدريب نموذج بمستوى Whisper، الذي تدرّب على أكثر من 680 ألف ساعة، من الصفر (وفقاً لـ ESPnet). ويتيح تردد 48 كيلوهرتز تدريب نماذج تحويل النص إلى كلام تولّد صوتاً غنياً وواضحاً. ومع مئات الآلاف من الساعات متعددة القنوات فعلاً، يمكن لتوليد الصوت المجسّم والمكاني أن يتجاوز مجموعات الاستوديو الصغيرة. أما الترجمات الإنجليزية المزودة بتوقيتات فتجعل المجموعة، بحسب الفريق، من أكبر الموارد المفتوحة لترجمة الكلام إلى نص. وتخدم الطوابع الزمنية على مستوى الكلمة مهام الترجمة المرئية والمحاذاة القسرية والنماذج التي تحتاج إلى معرفة لحظة نطق كل كلمة. كما يناسب الصوت عالي النطاق المسجّل في ظروف حقيقية، مع بيانات الجودة الوصفية، تدريب أنظمة ترميز الصوت (codecs) ونماذج تحسين الكلام التي يجب أن تتعامل مع ظروف تسجيل واقعية.
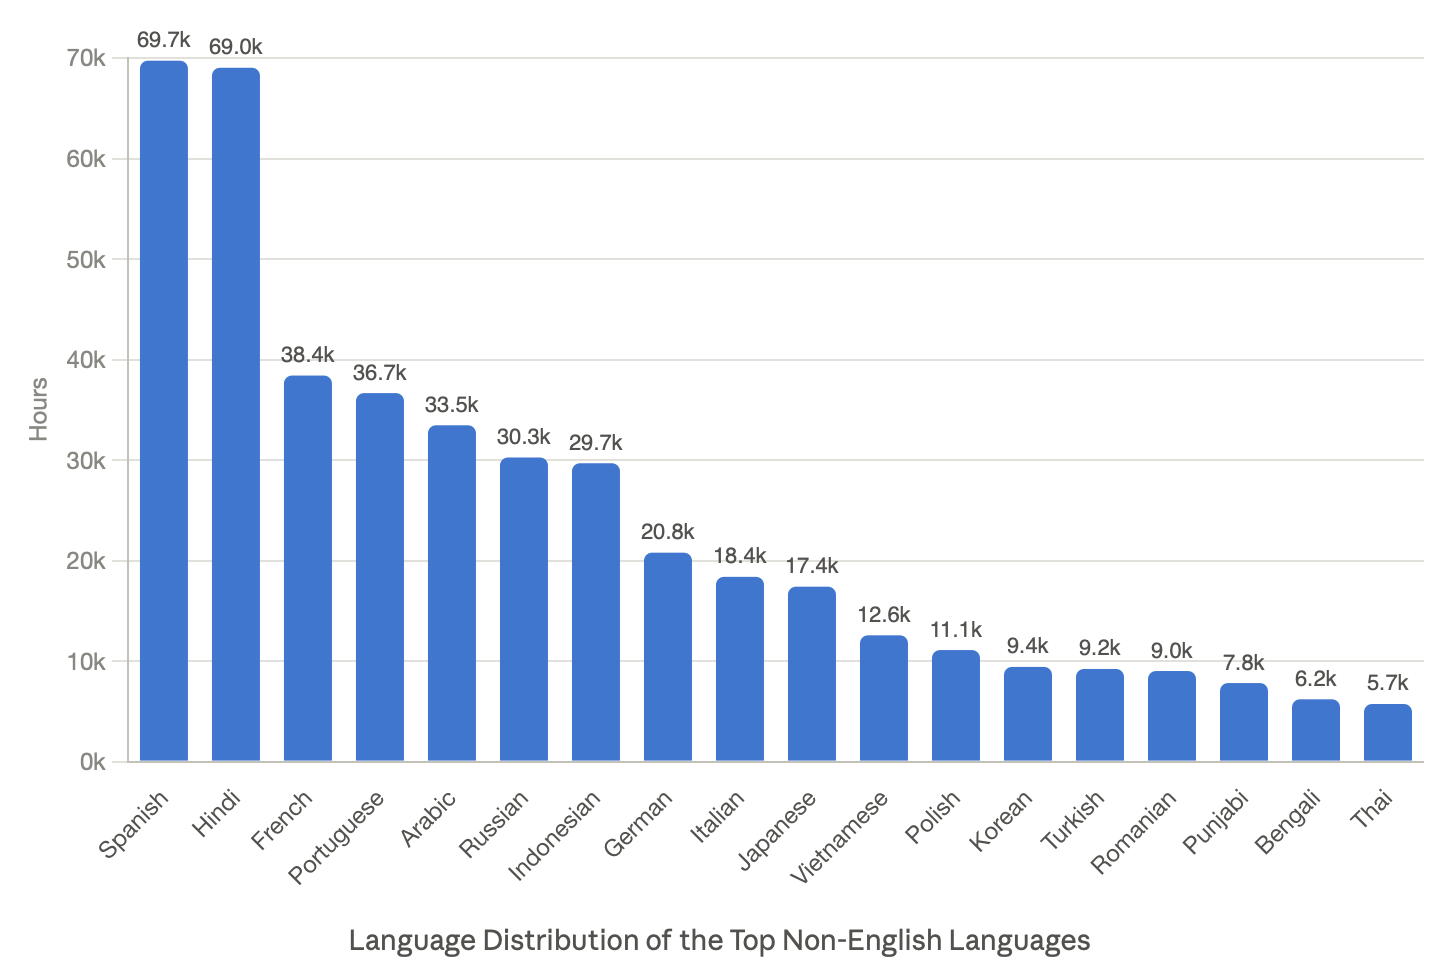
في المقابل، تبقى أسئلة عملية بلا جواب في الإعلان. فهو لا ينشر توزيع الساعات لكل لغة، وهو ما التقطه أحد المعلقين الذي سأل عن عدد ساعات الأذربيجانية. ولا يذكر الإعلان كذلك حصة اللغة العربية ولهجاتها، وهي المعلومة التي تهمك أكثر إن كنت تبني نموذجاً صوتياً عربياً، فلا بد من فحص بيانات اللغة بنفسك قبل الاعتماد عليها. ولاحظ معلق آخر غياب تسميات تبدّل المتحدثين ودرجات الثقة في المحاذاة، وهي أدوات تساعد على التعامل مع الحوارات متعددة المتحدثين وتصفية الترجمات النصية الرديئة القادمة من الويب. يضاف إلى ذلك أن 60 تيرابايت ليست حجماً يسهل على مختبر صغير تنزيله ومعالجته، وأن تفريغاً نصياً مصدره الويب يحتاج عادةً إلى تصفية قبل التدريب الجاد. فهل تكفي البيانات المفتوحة وحدها لتضييق الفجوة مع المختبرات المغلقة، أم أن الحوسبة ستبقى العائق التالي؟
المصادر
- YODAS v3: A 1 Million Hour Dataset for the Next Generation of Open Voice AI Research huggingface.co
- espnet/yodas · Datasets at Hugging Face huggingface.co
- GitHub – facebookresearch/libri-light github.com
- GitHub – facebookresearch/voxpopuli github.com
- People’s Speech Dataset | MLCommons Datasets mlcommons.org