نماذج الصدارة تتقن استرجاع آخر قيمة، لكن دقتها تهبط إلى 13% أو أقل حين تترابط التحديثات، بينما تعمّم Gated DeltaNet حتى 250 ضعف طول تدريبها.
ضمن ملف: نماذج الذكاء الاصطناعي، جوجل والذكاء الاصطناعي
بقلم: سارة | محررة نماذج الذكاء الاصطناعي · صوت تحريري بإشراف بشري
المصدر الأساسي: Ai2 Blog on Hugging Face
لماذا يهم
المطورون الذين يبنون وكلاء يقرأون قواعد كود أو سجلات طويلة يعتمدون على تتبع الحالة دون اختبار صريح له، وStateBench يمنحهم ومصممي المعماريات أداة لقياس أين ينهار النموذج فعلاً.
تهبط دقة أقوى النماذج التجارية اليوم إلى 13% أو أقل عندما يُطلب منها تتبع سلسلة طويلة من التغييرات المترابطة داخل وثيقة واحدة (وفقاً لـ مدونة Ai2 على Hugging Face). هذه هي النتيجة الأبرز في StateBench، المعيار الجديد الذي أعلنه معهد Ai2 في 3 نوفمبر 2026. يقيس المعيار قدرة النماذج اللغوية على متابعة ما يحدث للكيانات عبر السياقات الطويلة، وقد اختُبرت عليه أربعة نماذج من الصف الأول: Gemini 3.8 Flash وClaude Opus 5.5 وGPT-6 Sol وGPT-6 Luna. جميع الأرقام الواردة هنا مصدرها الجهة التي صممت المعيار وأجرت التجارب، أي أنها أرقام معلنة من الجهة نفسها. ولم يتسنَّ التحقق منها بشكل مستقل حتى الآن، فالقصة تقوم على مصدر وحيد هو Ai2 عبر مدونتها وتقريرها التقني.
تتبع الحالة مهارة نمارسها دون أن ننتبه لها. حين تقرأ كوداً تُسند فيه قيمة لمتغير ثم يُعاد إسنادها، أو تتابع رواية يتنقل أبطالها وتنتقل الأشياء بين أيديهم، فأنت تحدّث في ذهنك “حالة” كل كيان. تضرب Ai2 مثالاً من رواية بوليسية: إذا ورد أن “جون أعطى ماري السكين” قبيل وقوع جريمة، فمعرفة أن حالة الشخصيتين تغيّرت مسألة حاسمة. لكن النسخة الأصعب من اللغز تأتي حين تقول الرواية إن جون أعطى ماري “ما في حقيبته”، بعد أن ذكرت في موضع سابق أن إدوارد وضع سكيناً في حقيبة جون. هنا لا يكفي العثور على آخر تحديث، بل يجب تتبع سلسلة كاملة، وخطوة واحدة مفقودة تُفسد الجواب النهائي.
لهذا السؤال خلفية معمارية واضحة. فبحسب Ai2، للمحوّلات (Transformers) حدود نظرية موثّقة جيداً في الأنواع الصعبة من تتبع الحالة ذات سلاسل الاعتماد الطويلة، وهي حدود ناقشتها أعمال سابقة مثل ورقة The Illusion of State in State-Space Models. وهذا من الدوافع وراء صعود المعماريات التكرارية والهجينة مثل Gated DeltaNet، التي تحمل ذاكرة جارية إلى الأمام. المشكلة أن الاختبارات الموجودة تركّز على أصعب الحالات فقط، بينما يحتاج الباحثون إلى معرفة ما تستطيعه كل معمارية في الحالات الأبسط أيضاً، وهي على الأرجح الأكثر شيوعاً في الاستخدام الفعلي.
يقسّم StateBench المشكلة إلى أربعة مستويات صعوبة، ويشرحها بلغة المبرمجين كأنواع مختلفة من إسناد المتغيرات. المستوى الأول R-trivial يستخدم إسناداً ثابتاً لا يتغير، مثل let x = 4، ومقابله في الحياة اليومية تاريخ الميلاد. والمطلوب فقط استرجاع القيمة الأولى. المستوى الثاني Aperiodic يسمح بإعادة الإسناد بالقيمة، مثل x = 4 ثم لاحقاً x = 2، تماماً كمنظّم الحرارة الذي يحدد آخر ضبط له درجة الحرارة الحالية. هنا يكفي إيجاد أحدث قيمة وتجاهل ما سبقها. المستوى الثالث Soluble يضيف التحديثات المرجعية الذاتية مثل x = x + 5، كنتيجة مباراة تُضاف كل نقطة فيها إلى المجموع الجاري، فيضطر النموذج إلى حمل التغييرات إلى الأمام بدل البحث عن آخر إسناد. أما المستوى الرابع General finite فيضيف الإسناد بالمرجع، مثل x = y أو تبديل متغيرين، فتنشأ اعتمادات متشابكة بين التحديثات.
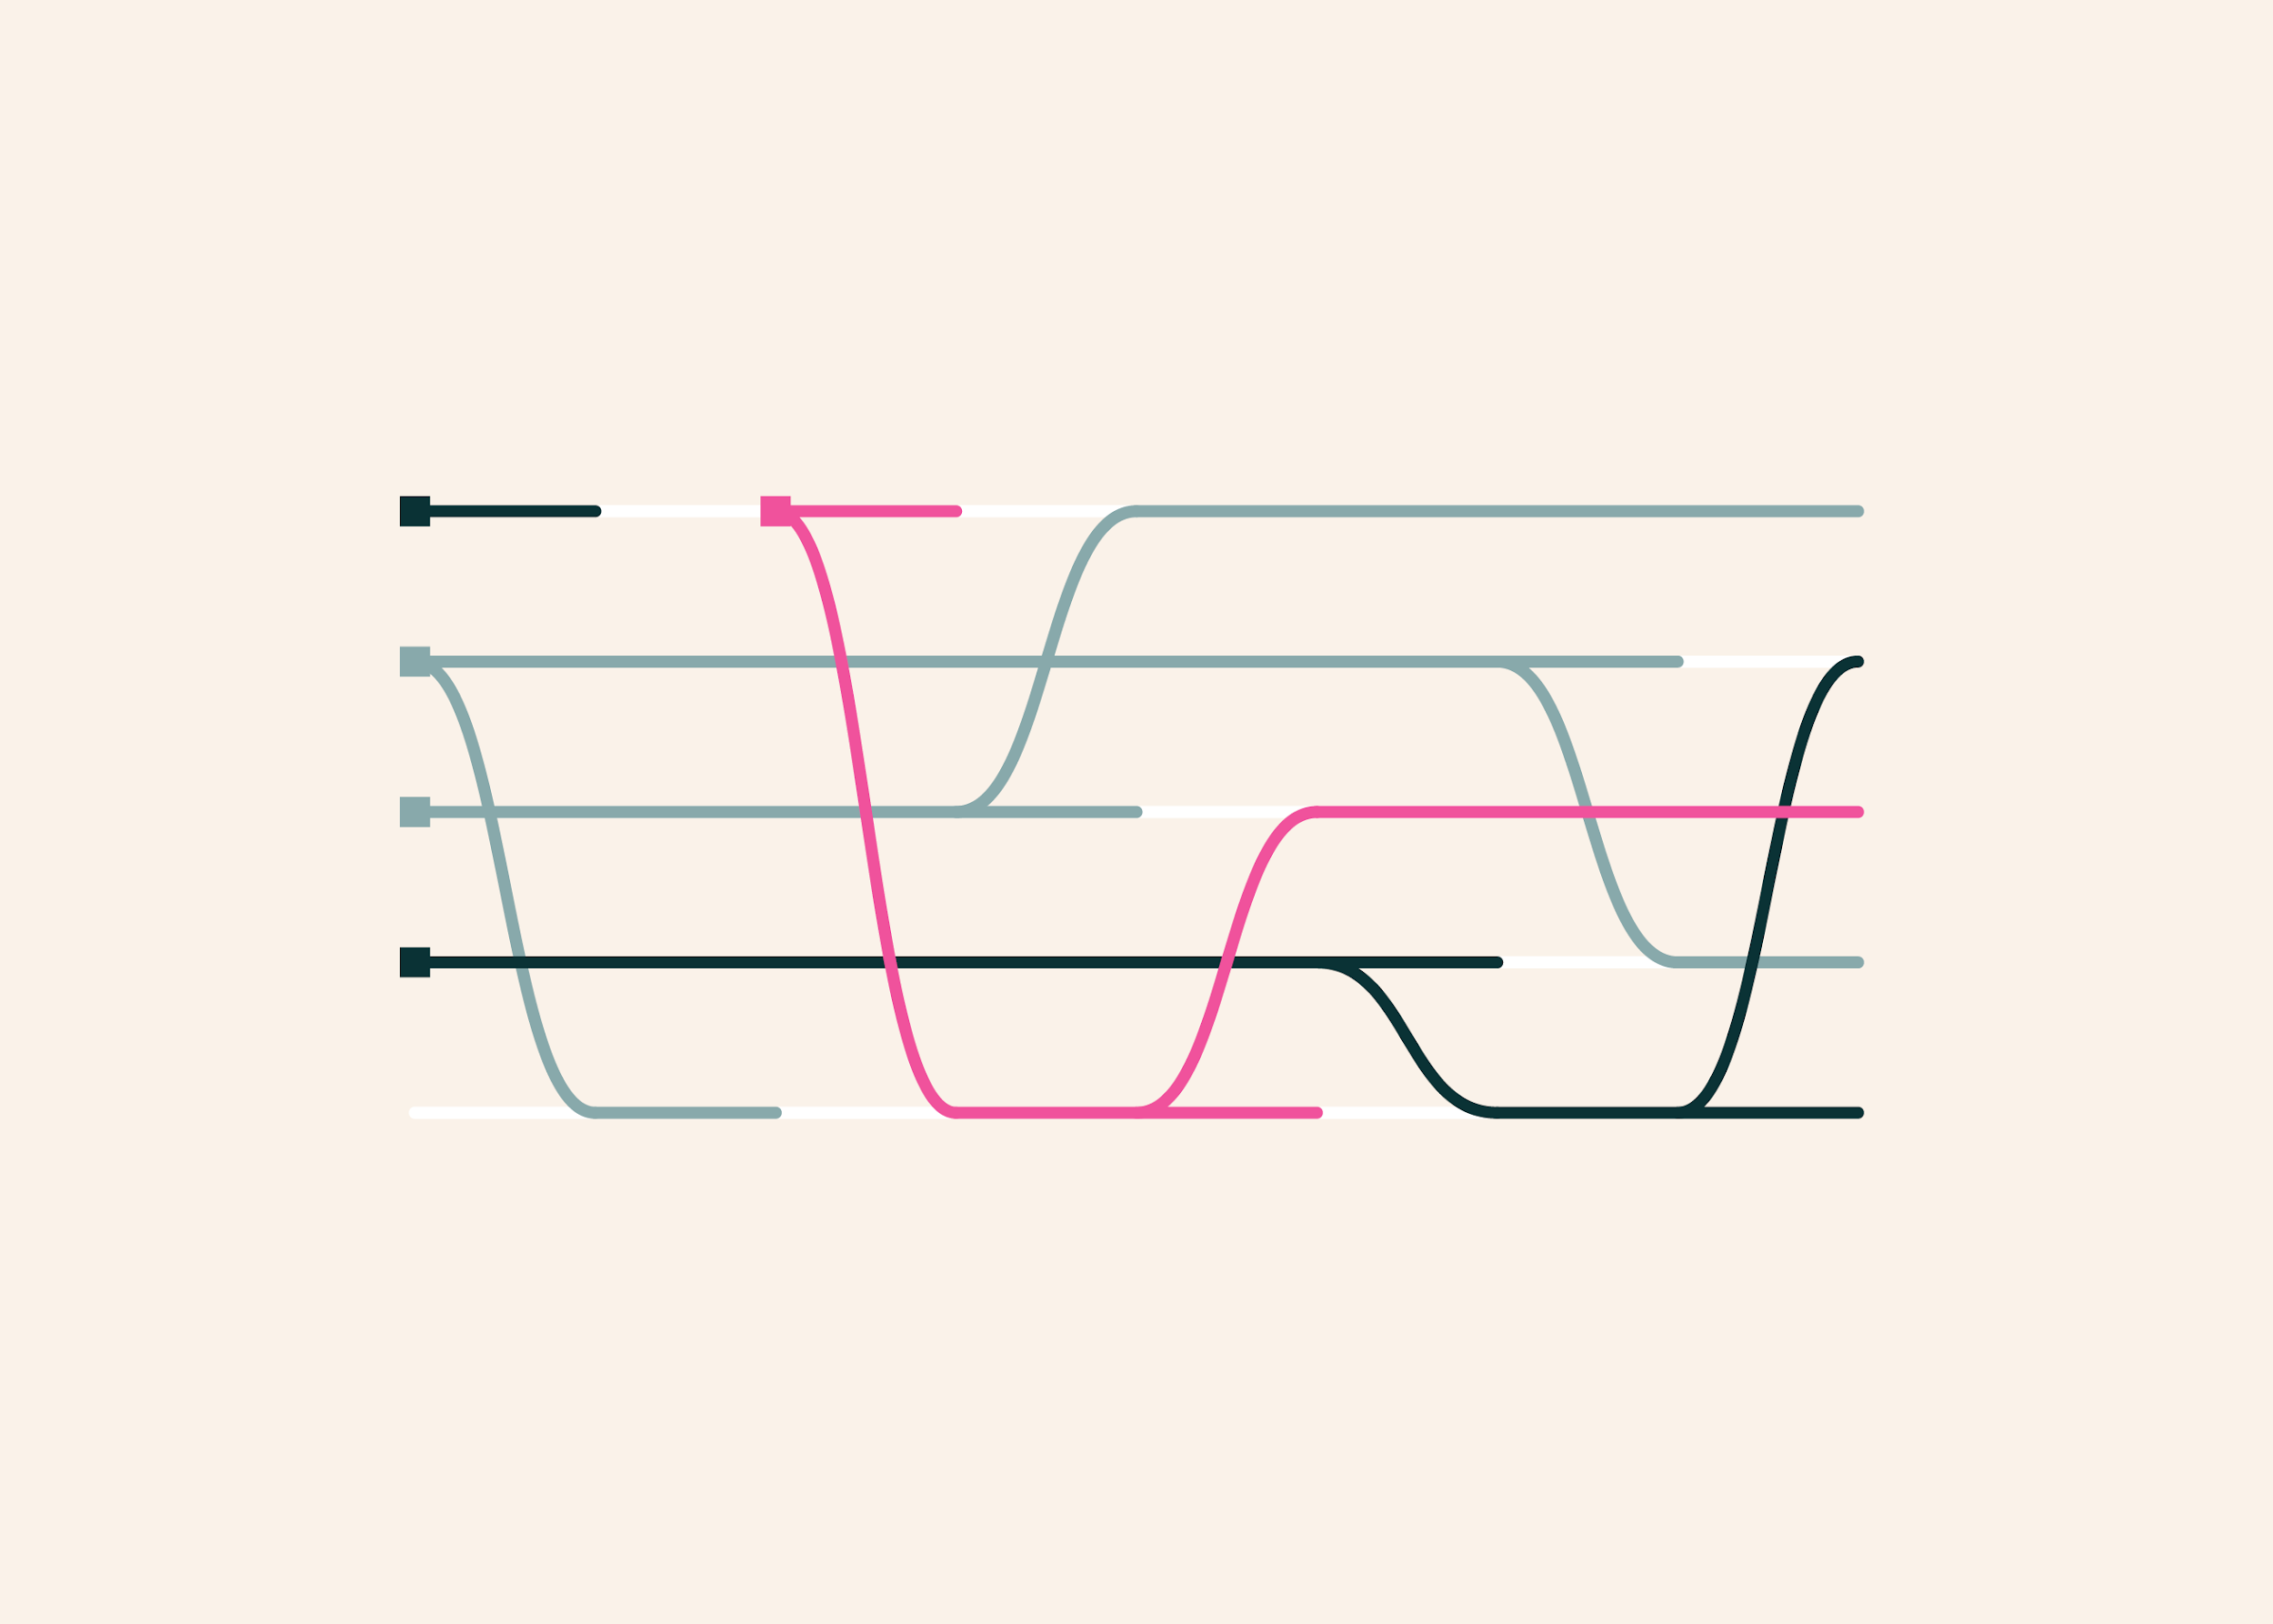
أوضح صورة للمستوى الأخير هي الساحر الذي يخفي كرة تحت واحد من خمسة أكواب ثم يبدّل مواقعها مراراً. إيجاد الكرة يعني تتبع كيف غيّرت كل عملية تبديل موقعها، وهذه هي مسألة S₅: متابعة كيف تعيد التبديلات المتتالية ترتيب خمسة أشياء. هذه المستويات ليست تقسيماً حدسياً فقط، إذ تستند بحسب Ai2 إلى نظرية Krohn-Rhodes، وهي فرع من الجبر يصف كيف يمكن تفكيك مسائل تتبع الحالة، التي يمكن النظر إليها كمسائل كلمات على مونويدات منتهية، إلى عناصر أولية ذرّية. كل مستوى يقابل فئة من المسائل تُبنى من مجموعة مختلفة من هذه العناصر. ولضمان مقارنة عادلة، يبدأ الفريق بتسلسل عام من الإسنادات ويشتق منه ثلاث نسخ أسهل. تستخدم المسائل الأربع العدد نفسه من المتغيرات والقيم المتمايزة، وتظهر الإسنادات في المواضع نفسها، ولا يتغير سوى نوع الإسناد. هذا التصميم المضبوط في رأينا هو أقوى ما في المعيار، لأنه يعزل متغيراً واحداً فقط هو طبيعة التحديث.
وهذه أبرز النتائج كما عرضتها Ai2:
- النماذج المفتوحة المدرَّبة مسبقاً تتوقف عند الصدفة في المستوى الأصعب. اختبر الفريق نموذجين بحجم 7 مليارات معامل: Olmo 3 (محوّل) وOlmo Hybrid (يضيف طبقات Gated DeltaNet)، إلى جانب نماذج أصغر بحجم 275 مليون و2.7 مليار معامل (وفقاً لـ مدونة Ai2 على Hugging Face). دُرّبت كلها على البيانات نفسها، ولم يرَ أي منها سياقاً أطول من 64 ألف token أثناء التدريب، واختُبر معظمها على مدخلات تتجاوز ذلك بكثير (وفقاً لـ مدونة Ai2 على Hugging Face). أداء شبه جميعها كان جيداً في R-trivial، وتراجع في Aperiodic مع طول المدخلات، وبقي عند مستوى الصدفة في General finite. لم تُنشر نتائج المستوى Soluble لهذه النماذج. ويتوافق هذا مع التوقع النظري: المحوّلات تتعامل بثبات مع R-trivial، ومع Soluble وAperiodic بدرجة ما، ويُتوقع فشلها في المستوى العام، بينما يستطيع Gated DeltaNet بتحديث ذاكرة أكثر مرونة نظرياً التعامل مع المستويات الأربعة.
- صيغة المسألة تغيّر النتيجة جذرياً. حقق النموذجان الهجين وGated DeltaNet بحجم 275 مليون معامل نتائج قريبة من السقف في مسائل R-trivial بصيغة RULER، لكنهما اقتربا من الصدفة في المسائل نفسها حين صيغت كتعديلات على جدول بيانات (وفقاً لـ مدونة Ai2 على Hugging Face). لهذا السبب يختبر StateBench المسألة الأساسية نفسها بعدة صيغ.
- نماذج الصدارة تنهار في المستويين الأصعب. طُلب من Gemini 3.8 Flash وClaude Opus 5.5 وGPT-6 Sol وGPT-6 Luna قراءة كل تسلسل وإخراج القيمة النهائية لكل متغير. أبلت النماذج الأربعة جيداً في R-trivial وAperiodic، لكن دقتها هبطت بحدة في Soluble وGeneral finite مع طول المدخلات، لتصل إلى 13% أو أقل في أطول مسائل General finite (وفقاً لـ مدونة Ai2 على Hugging Face). تفسير Ai2 المرجّح هو “الحساسية”: في هذه المستويات تؤثر خطوات أكثر بكثير في الجواب النهائي، فيضيق هامش تفويت أي تحديث دون إفساد النتيجة.
- التدريب المباشر يكشف الفرق بين المعماريات. درّب الفريق من الصفر عدة نماذج بحجم 275 مليون معامل على StateBench: نسختان من المحوّل، ونسختان هجينتان، ونسختان من Gated DeltaNet بقيود مختلفة على تحديث الذاكرة. تدرّبت النماذج على تسلسلات حتى 256 إسناداً واختُبرت على تسلسلات تصل إلى 64 ألف إسناد، أي 250 ضعف أقصى طول تدريبي (وفقاً لـ مدونة Ai2 على Hugging Face). عمّم Gated DeltaNet والنماذج الهجينة بشكل شبه مثالي في R-trivial وAperiodic وSoluble حتى أطول التسلسلات المختبرة، أي عشرات الآلاف من الإسنادات. أما المحوّلات فتعلّمت المستويات الأسهل لكنها تراجعت مع طول التسلسلات، ولم تتعلم General finite أبداً.
- الذاكرة المرنة تذهب أبعد في المستوى الأصعب. في General finite، عمّمت نسخة Gated DeltaNet ذات التحديث الأكثر مرونة لأبعد مدى، وبقيت قريبة من الكمال حتى نحو 10 أضعاف طول أطول تسلسل رأته في التدريب (وفقاً لـ مدونة Ai2 على Hugging Face). تستنتج Ai2 أن الفجوة لدى Gated DeltaNet والهجينة تعود إلى التدريب لا المعمارية، فقد تعلمت مستويات عجزت عنها نظيراتها المدرّبة مسبقاً. أما المحوّلات فحتى مع التدريب المباشر لم تتعلم المستوى الأصعب.
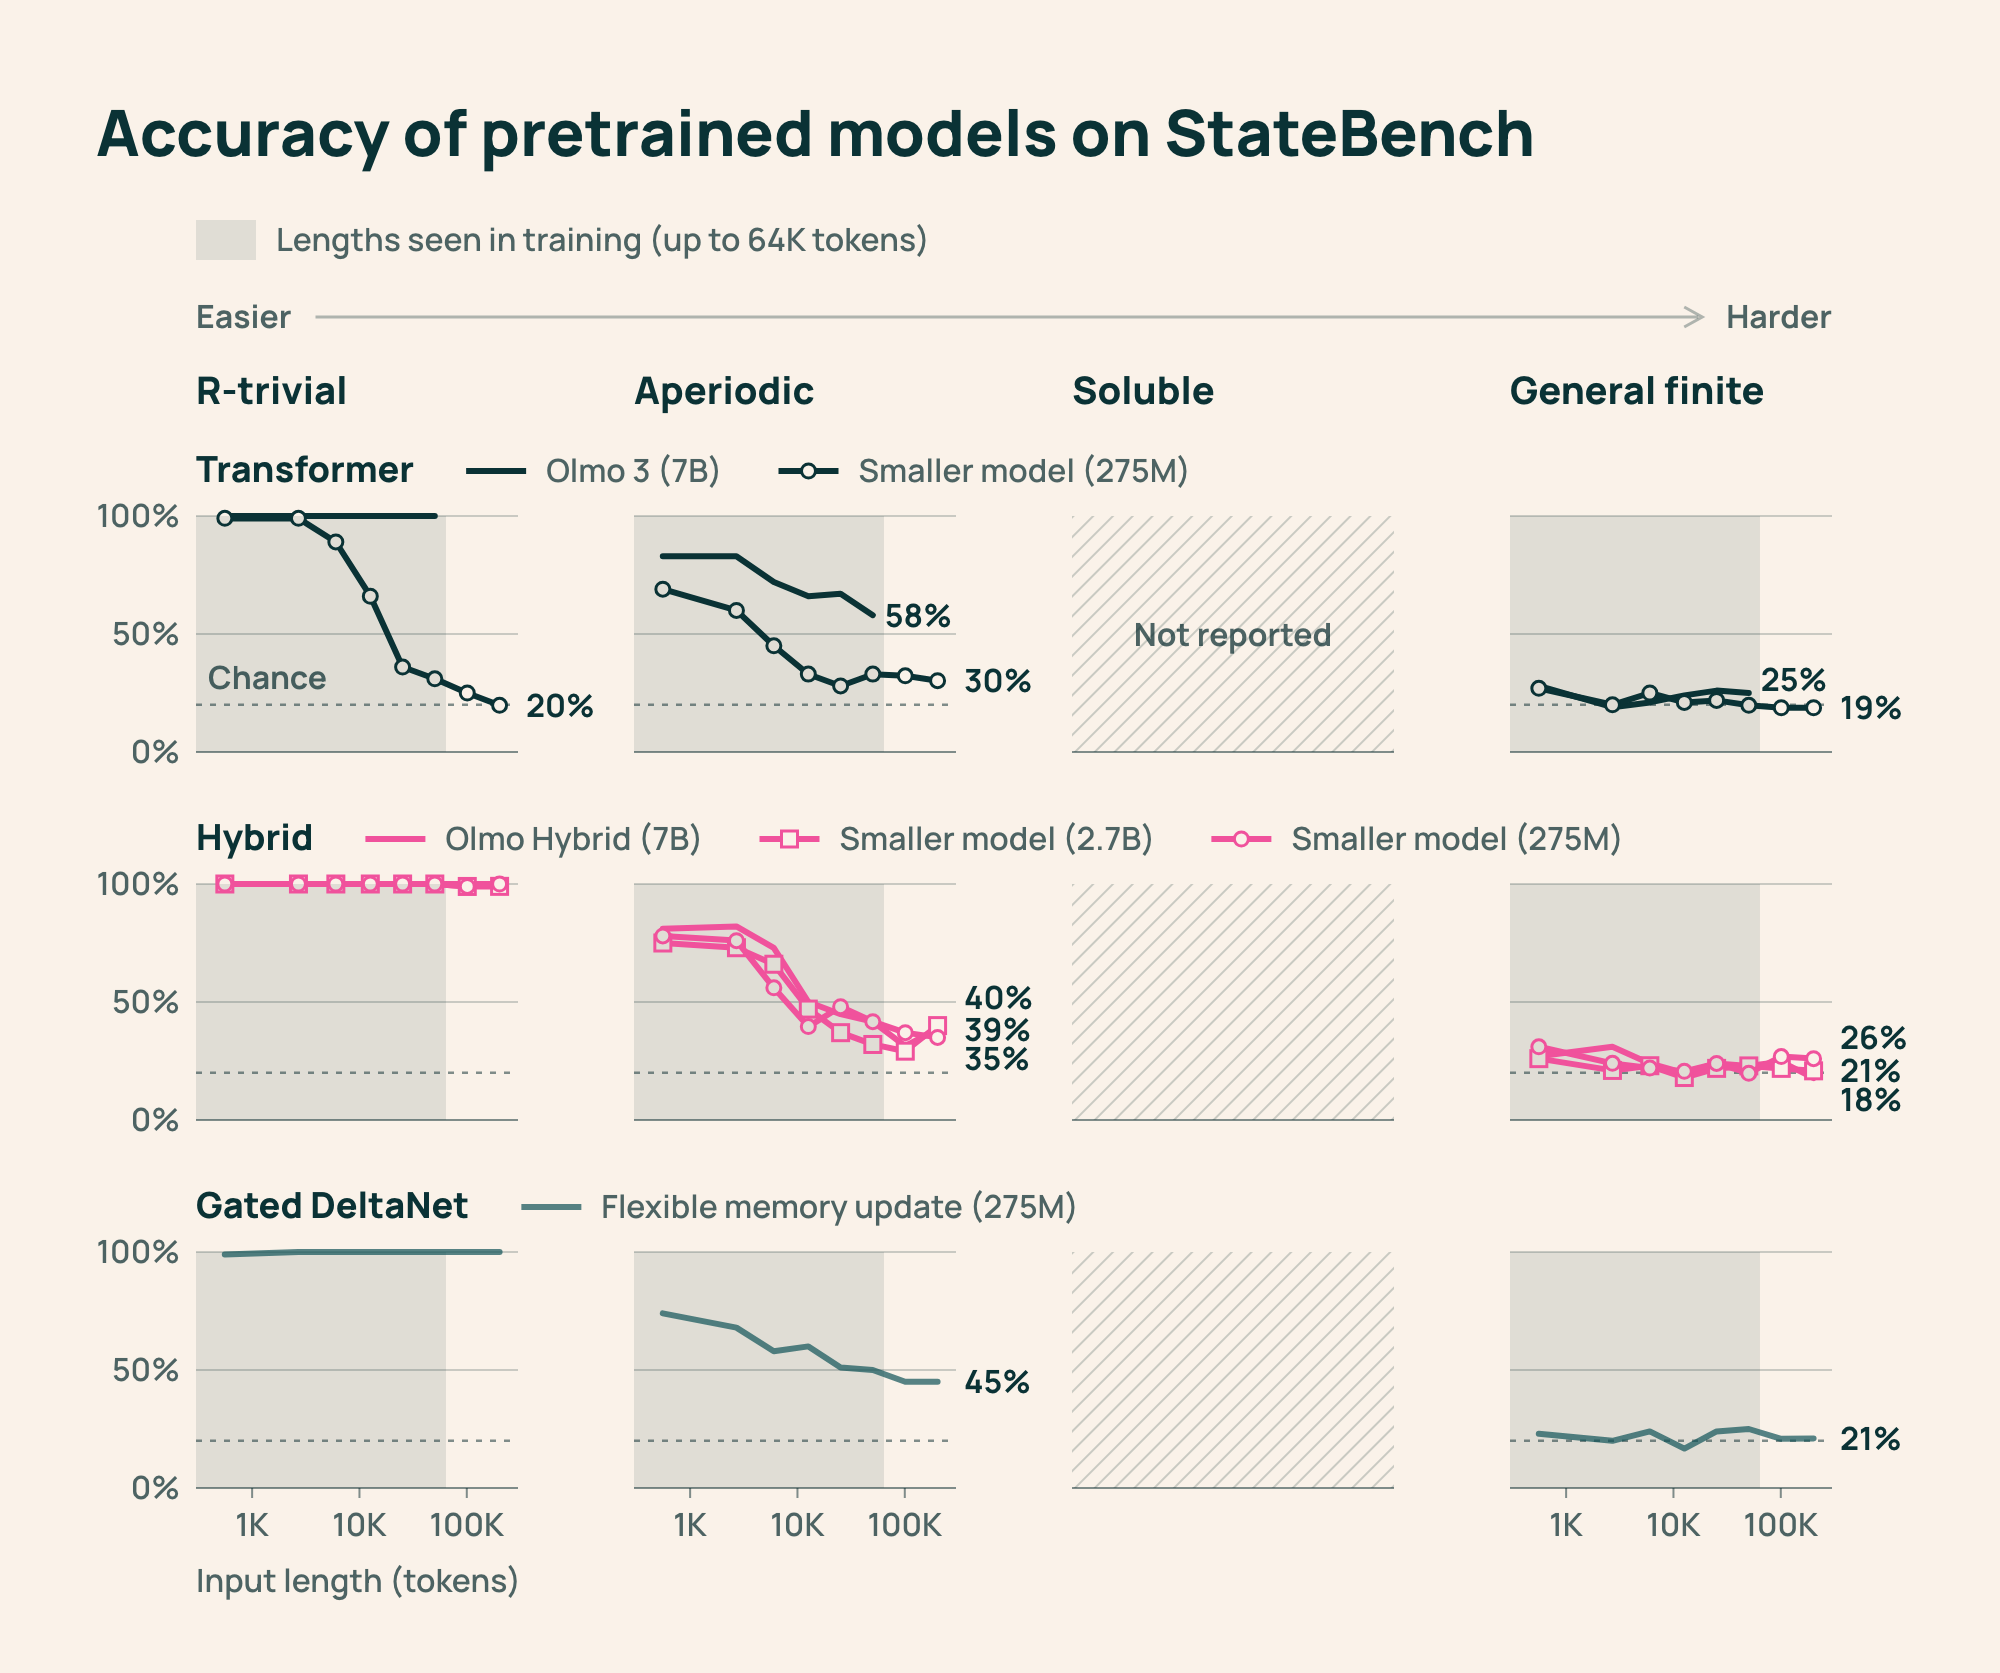
لاحظ في الرسم أعلاه كيف تبقى خطوط R-trivial مرتفعة بينما تلتصق خطوط General finite بمستوى الصدفة مهما كانت المعمارية، وهو ما يعني أن التدريب المسبق وحده لا يعلّم المهارة الأصعب.
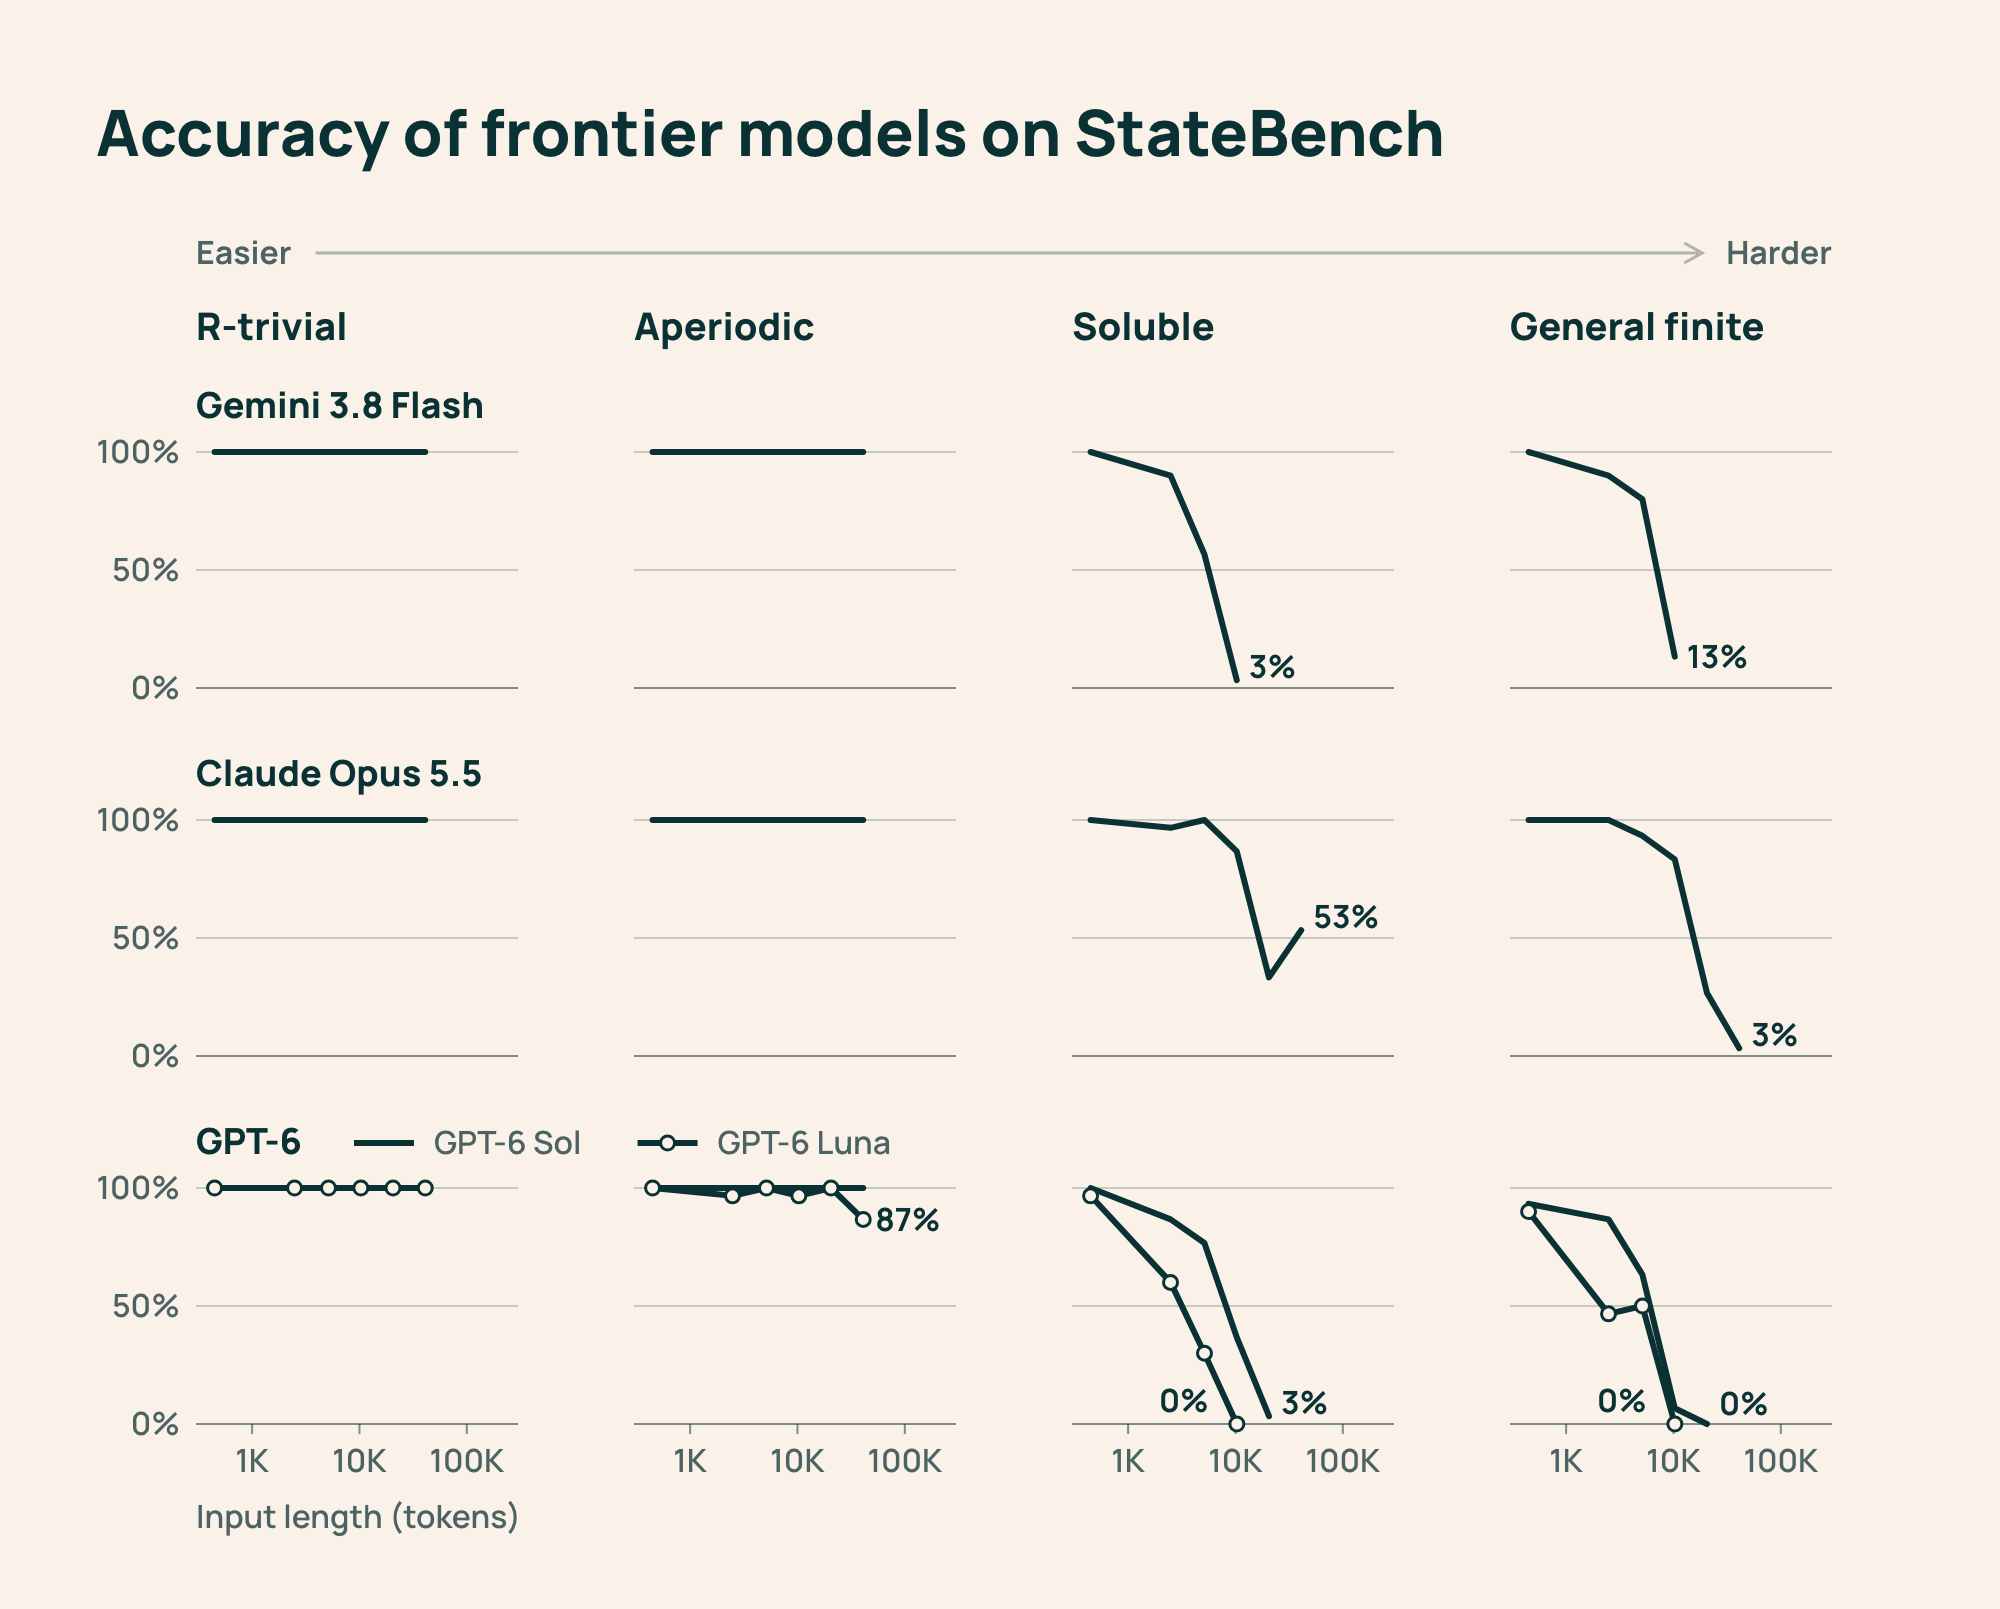
أهم ما يُقرأ في الرسم الثاني هو انحدار منحنيات Soluble وGeneral finite مع تزايد التوكنات، مقابل ثبات المستويين الأسهل لدى النماذج الأربعة.
لا يدّعي الفريق أنه أغلق الملف. فبحسب Ai2، يُثبت برهان جديد في الورقة أن Gated DeltaNet بتحديث ذاكرة أكثر محدودية (قيم ذاتية غير سالبة) يستطيع حل جميع مهام Aperiodic وبعض المهام الدورية، مثل تتبع ما إذا تكرر مدخل ما عدداً زوجياً أو فردياً من المرات، وذلك ضمن حساب بدقة ثابتة مع التقريب كما تفترض الورقة. لكن موقعه الدقيق في التسلسل الهرمي ما زال مفتوحاً، بما في ذلك قدرته على حل كل مهام Soluble، وأثر الدقة العددية أو دمجه مع طبقات الانتباه. وهناك قيد بنيوي أوضح: يفترض StateBench عدداً ثابتاً من المتغيرات، بينما تُدخل المهام الحقيقية كيانات جديدة بمرور الوقت. في محادثة طويلة مثلاً يظهر أشخاص وأشياء جدد ويتعين على النموذج البدء بتتبعهم، وهذا ما لا يغطيه الإطار الحالي بعد.
ماذا يعني هذا لك إن كنت تبني وكيلاً يقرأ قاعدة كود كاملة أو يتابع سجل معاملات طويلاً؟ يعني أن نجاح النموذج في استرجاع معلومة من وسط مليون token لا يضمن أنه يفهم كيف تغيّرت تلك المعلومة عبر الطريق. اختبارات “الإبرة في كومة القش” تقيس المستوى الأسهل تقريباً، وStateBench يُظهر أن الانهيار يبدأ حين تصبح التحديثات مترابطة. نرى أن قيمة المعيار الحقيقية ليست في ترتيب النماذج، بل في تفكيك “السياق الطويل” إلى قدرات منفصلة يمكن قياسها وتدريبها، مع التحفظ بأن معظم الأدلة على تفوق المعماريات التكرارية جاءت من نماذج صغيرة مدرّبة مباشرة على المهمة. أتاحت Ai2 البيانات على Hugging Face والكود على GitHub، وتأمل أن يكون المعيار “نجم الشمال” لمن يطوّر معماريات أكثر متانة في تتبع الحالة.
المصادر
- StateBench: Testing how language models track state changes over long documents huggingface.co
- A Fine-Grained Hierarchy and Benchmark for State Tracking in Language Models allenai.org
- allenai/state-bench · Datasets at Hugging Face huggingface.co
- GitHub – allenai/state-bench github.com
- The Illusion of State in State-Space Models arxiv.org