بعد فتح FlashMLA وDeepGEMM وDeepEP كلاً على حدة، تكشف DeepSeek الآن كيف تجمعها في محرك إنتاجي واحد يعمل على NVIDIA وHuawei معاً.
ضمن ملف: نماذج الذكاء الاصطناعي، إنفيديا
بقلم: ليلى | محررة أدوات المطورين · صوت تحريري بإشراف بشري
المصدر الأساسي: GitHub (deepseek-ai/DeepInfer)
لماذا يهم
فرق البنية التحتية والباحثون الذين يشغّلون نماذج MoE كبيرة يحصلون على مرجع إنتاجي مفتوح لميزات مثل الحتمية والتسريع بالمسودّات، لكن من يعمل على عتاد أقدم من SM100 لن يستفيد منه بعد.
نشرت DeepSeek الكود المصدري لـ DeepInfer، وهو إطار الـ inference الذي تقول إنه يشغّل خدماتها الإنتاجية واسعة النطاق. الإصدار مفتوح تحت رخصة Apache 2.0 (وفقاً لـ GitHub DeepSeek). تعتمد هذه القصة على مصدر وحيد هو مستودع الشركة على GitHub، ولم نجد حتى الآن تغطية مستقلة أو اختبارات من طرف ثالث. وصف المحرك بأنه “عالي الأداء” هو توصيف الشركة لنفسها ولم يتسنَّ التحقق منه بشكل مستقل.
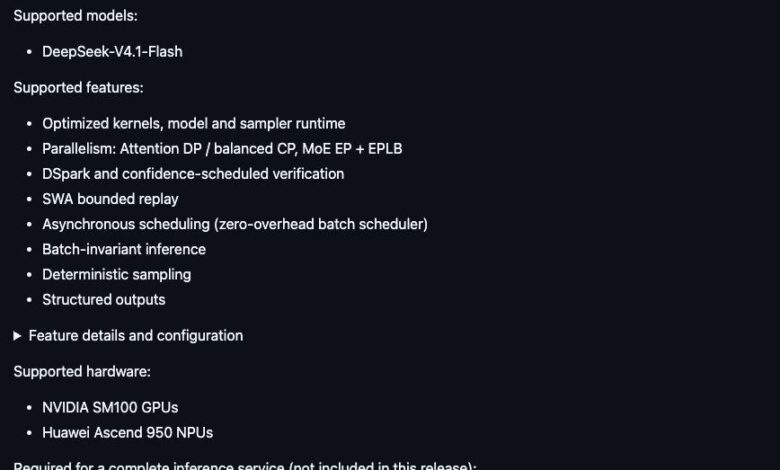
يقتصر الإصدار الحالي على الاستدلال الـ offline. يدعم نموذجاً واحداً هو DeepSeek-V4.1-Flash، ويعمل على فئتين من العتاد: وحدات NVIDIA SM100 ووحدات Huawei Ascend 950 (وفقاً لـ GitHub DeepSeek). وتقرّ الشركة بأن المحرك بُني في الأصل على vLLM بشكل أساسي، واستلهم أفكاراً إضافية من SGLang وTensorRT-LLM.
تحت الغطاء تجمع DeepSeek مكتبات النوى التي فتحتها تباعاً خلال الفترة الماضية: FlashMLA لنوى الانتباه الكامن متعدد الرؤوس، وDeepGEMM لعمليات ضرب المصفوفات، وDeepEP للاتصال بين الخبراء في نماذج MoE. ويضاف إليها TileKernels وDeepSelect ونوى مخصصة مكتوبة بلغة TileLang. وعلى مستوى التوازي يدعم المحرك Attention DP مع Context Parallelism متوازن، وExpert Parallelism لنماذج MoE مع موازنة الأحمال EPLB. نحن نرى أن هذه هي القطعة التي كانت ناقصة. فالمكتبات المتفرقة كانت مفيدة لمن يبني محركه الخاص، أما الآن فتظهر للمرة الأولى طريقة تركيبها معاً في خدمة فعلية.
أبرز ما في الحزمة ميزتان. الأولى هي DSpark مع التحقق المجدول بالثقة: يولّد المحرك رموزاً مسودّة لتسريع الـ decoding، ثم يستخدم تقديرات الثقة لتحديد متى يتحقق منها. والثانية هي SWA bounded replay، التي تقلل عمل الـ prefill في المفكك بإعادة تشغيل لاحقة محدودة من السياق فقط بدل السياق كاملاً. ويضاف إلى ذلك جدولة غير متزامنة تُداخل جدولة الدفعات على المعالج المركزي مع التنفيذ على المسرّع، وهي مفعّلة افتراضياً وتصفها الشركة بأنها “بلا كلفة إضافية”. وهناك أيضاً استدلال ثابت النتائج مهما تغيّر تركيب الدفعة، وأخذ عينات حتمي، ومخرجات منظمة.
إذا أردت تجربة المحرك بنفسك، فهذه الخطوات كما يوثقها المستودع (وفقاً لـ GitHub DeepSeek):
- جهّز البيئة. تحتاج إلى نظام Linux وGCC بإصدار 13.0 أو أحدث، وPython 3.12. أضف CUDA 13 إن كنت على NVIDIA، أو CANN 9.2 إن كنت على Ascend. وأنشئ بيئة Python 3.12 فارغة وفعّلها قبل البناء (وفقاً لـ GitHub DeepSeek).
- حدد المسرّع وابنِ من المصدر. صدّر المتغير
DEEPINFER_ACCELERATOR=nvidia، أو استخدم القيمةascendعلى منصة Huawei، ثم شغّل./build.sh. يجب أن يبقى المتغير مُصدَّراً في البيئة التي ستشغّل فيها المحرك لاحقاً. - شغّل أول استدلال. نفّذ
python examples/offline_inference.py. في التشغيل الأول تُنزَّل نقطة الحفظ الافتراضية DeepSeek-V4.1-Flash-1017 إلى ذاكرة Hugging Face المؤقتة. ولتشغيل نسخة محلية بدلاً من ذلك، اضبطDEEPINFER_HF_MODEL_DIRعلى مسار المجلد. - فعّل التسريع بالمسودّات. اضبط
DEEPINFER_ENABLE_MTP_VARLEN=1لتشغيل DSpark. ويتحكمDEEPINFER_USE_NEXTN_DECODEفي أقصى طول للمسودّة، وقيمته الافتراضية 5 رموز (وفقاً لـ GitHub DeepSeek). - قلّص عمل الـ prefill. لاستخدام إعدادات V4.1 الافتراضية اضبط
DEEPINFER_YOCO_PREFILL_TRUNCATION_MODE=compactوDEEPINFER_YOCO_PREFILL_KEEP_TOKENS=140(وفقاً لـ GitHub DeepSeek). وتنبّه الوثائق إلى أن اللاحقة المحتفظ بها يجب أن تغطي نافذة SWA مضافاً إليها أقصى طول للتراجع. - اطلب نتائج حتمية أو مخرجات منظمة. لثبات النتائج بين الدفعات المختلفة فعّل
DEEPINFER_BATCH_INVARIANT=1. وللحصول على مخرجات متطابقة لنفس المدخلات أضف إليهDEEPINFER_ENABLE_MTP_VARLEN=0، ومرّر قيمةseq_seedثابتة إلىSamplingParams، علماً بأن الميزتين متاحتان على NVIDIA فقط. ولتقييد التوليد بتعبير regex أو JSON schema أو قواعد EBNF، مرّرso_args={"schema_type": ..., "schema": ...}إلىSamplingParams.
ما يجب أن تعرفه قبل أن تعتبر هذا الإصدار بديلاً جاهزاً لـ vLLM أو SGLang هو أنه ليس خدمة كاملة. تقول DeepSeek صراحة إن ثلاثة مكونات لازمة لخدمة استدلال متكاملة غير مشمولة. الأول نظام لذاكرة KV cache. والثاني فصل مراحل VE وPrefill وDecode، مع أن معظم وظائف المحرك اللازمة لذلك منفذة بالفعل بحسب الشركة. والثالث موازنة الأحمال بين نسخ التوازي في البيانات لمرحلتي الـ prefill والـ decode. بعبارة أخرى، حصلت على المحرك، أما البنية التي تحوّله إلى API يخدم آلاف الطلبات فعليك بناؤها بنفسك.
العتاد قيد آخر. فالمحرك لا يدعم حالياً إلا SM100، أي جيل Blackwell من NVIDIA، وAscend 950، ولا يدعم إلا نموذجاً واحداً. أي فريق يعمل على Hopper أو على بطاقات المستهلكين خارج الحسبة في هذه المرحلة. والأداء المعلن نفسه قيس على 4 وحدات SM100 للـ prefill و64 وحدة للـ decode، كل منها داخل نطاق scale-up واحد (وفقاً لـ GitHub DeepSeek). يعرض المستودع نتائج الأداء على شكل رسوم بيانية، وهي أرقام معلنة من الشركة نفسها ولم يتسنَّ التحقق منها بشكل مستقل، لكن الشركة توفر سكربت run_sweep.sh لإعادة إنتاجها، ومعايير التقييم موثقة في eval/README.md.
في تقديرنا، دعم NVIDIA وHuawei معاً في محرك إنتاجي واحد هو الإشارة الأهم في هذا الإصدار، وأهم من أي رقم سرعة. فهو يوحي بأن DeepSeek تصمم بنيتها لتعمل على العتاد الصيني بالتوازي مع العتاد الأمريكي، لا كخطة بديلة مؤجلة. هذه قراءة تحريرية، ولم تذكرها الشركة في وثائقها. أما للمطورين، فالقيمة الحقيقية الآن تعليمية وبحثية: ترى بنفسك كيف تُشغَّل نماذج MoE ضخمة في الإنتاج، مع ميزات مثل الحتمية والمخرجات المنظمة نادراً ما تُكشف تفاصيلها بهذا الوضوح. وقبل الاعتماد عليه في بيئة إنتاجية، انتظر أول تقارير أداء مستقلة.
المصادر
- GitHub – deepseek-ai/DeepInfer: DeepInfer: High-performance, large-scale inference framework for DeepSeek models github.com
- GitHub – deepseek-ai/FlashMLA: FlashMLA: Efficient Multi-head Latent Attention Kernels github.com
- GitHub – deepseek-ai/DeepGEMM: DeepGEMM: clean and efficient BLAS kernel library on GPU github.com
- GitHub – deepseek-ai/DeepEP: DeepEP: an efficient expert-parallel communication library github.com
- deepseek-ai/DeepSeek-V4.1-Flash-1017 · Hugging Face huggingface.co