بدل أسابيع من هندسة الميزات لكل مهمة، استعلام PQL واحد يكفي ليتنبأ النموذج من قاعدة البيانات، بدقة تفوق XGBoost بـ7 إلى 13 نقطة MRR.
ضمن ملف: إنفيديا، وكلاء الذكاء الاصطناعي
بقلم: نور | محررة الأبحاث والدراسات · صوت تحريري بإشراف بشري
المصدر الأساسي: Hugging Face Blog (NVIDIA)
لماذا يهم
فرق البيانات في الشركات التي تبني خط XGBoost مستقلاً لكل سؤال تنبؤي قد تستبدل ذلك بنموذج واحد واستعلام، كما يمنح الوكلاء قدرة على توقع سلوك العملاء والتصرف بناءً عليه.
أطلقت NVIDIA نموذج Kumo Relational، وهو نموذج أساس مدرَّب مسبقاً يعمل مباشرة على قواعد البيانات العلائقية في المؤسسات. تكتب استعلاماً تنبؤياً، فيجمع النموذج ما يصل إلى 10,000 مثال تاريخي كسياق، ثم يتنبأ بنتائج مثل تسرب العملاء أو الطلب أو الاحتيال في تمريرة أمامية واحدة (وفقاً لـ مدونة NVIDIA على Hugging Face). لا يحتاج النموذج إلى تدريب خاص بكل مهمة، ولا إلى هندسة ميزات، ولا إلى تسطيح الجداول في جدول واحد. وتقول الشركة إنه أول نموذج أساس من نوع few-shot يتفوق على التعلم الآلي الخاضع للإشراف في معايير البيانات العلائقية الشائعة: عبر 41 مهمة على 15 قاعدة بيانات، ويتعامل مع قواعد يتجاوز حجمها 500 مليار صف (وفقاً لـ مدونة NVIDIA على Hugging Face). هذه كلها أرقام معلنة من الشركة نفسها، ولم يتسنَّ التحقق منها بشكل مستقل حتى الآن.
تقوم الفكرة على مقارنة تطرحها NVIDIA صراحة. قبل سنوات كان كل نظام لمعالجة اللغة في الإنتاج يعني نموذجاً مستقلاً لكل مهمة، ولكل نموذج خط معالجة خاص من tokenization وlemmatization وn-grams. ثم جاءت نماذج LLM فجعلت هذا كله شبه متقادم لثلاثة أسباب: دقة أعلى من أفضل النماذج المتخصصة، وسهولة أكبر في النشر، ومرونة فتحت الباب للتطبيقات الوكيلية. تراهن NVIDIA على أن التحول نفسه يحدث الآن مع البيانات المهيكلة، حيث ما زال التنبؤ من قواعد البيانات يتطلب أسابيع من هندسة الميزات والتدريب الخاص وضبط الخطوط. وبحسب المدونة، يتفوق Kumo Relational على أشجار التعزيز التدرجي المبنية على ميزات صممها خبراء بنحو 4 نقاط AUROC في المتوسط على مهام التصنيف في RelBench V1، ويتفوق على XGBoost بميزات مهندسة في معيار SAP SALT بـ7 نقاط MRR دون أي ضبط، وبـ13 نقطة MRR بعد fine-tuning (وفقاً لـ مدونة NVIDIA على Hugging Face). الشركة تقولها بوضوح: هذه النتائج تبرر استبدال خطوط XGBoost في الإنتاج. والسبب الثالث في رهانها هو الوكلاء: نماذج LLM تمنح الوكيل القدرة على القراءة والكتابة والاستدلال، أما نماذج البيانات المهيكلة فتمنحه القدرة على توقع ما سيحدث، مثل معرفة العميل الذي سيغادر، ثم التصرف بناءً على ذلك.
تكمن الصعوبة التقنية في أن معظم نماذج الأساس للبيانات المهيكلة تعمل على جدول مسطح واحد، بينما تعيش البيانات الحقيقية في جداول مترابطة: مستخدمون مرتبطون بطلبات مرتبطة بمنتجات، وكلها تتغير مع الزمن. تسطيح هذه العلاقات يدوياً في صف واحد، بميزات من قبيل “متوسط قيمة الطلب في آخر 30 يوماً”، يُضيّع إشارات بنيوية دقيقة ويستهلك جهداً بشرياً كبيراً. يعمل Kumo Relational بدلاً من ذلك على القاعدة نفسها، ويحترم جداولها ومفاتيحها الأجنبية وطوابعها الزمنية. يُدرَّب مرة واحدة ثم يتكيف مع كل مهمة جديدة عبر التعلم في السياق، فيقرأ وقت الـinference ما يصل إلى 10,000 مثال. كل مثال يقرن رسماً فرعياً محلياً حول كيان ما في لحظة زمنية بقيمته الحقيقية، مثل “هذا المستخدم غادر” أو “هذا المنتج باع 142 وحدة”.
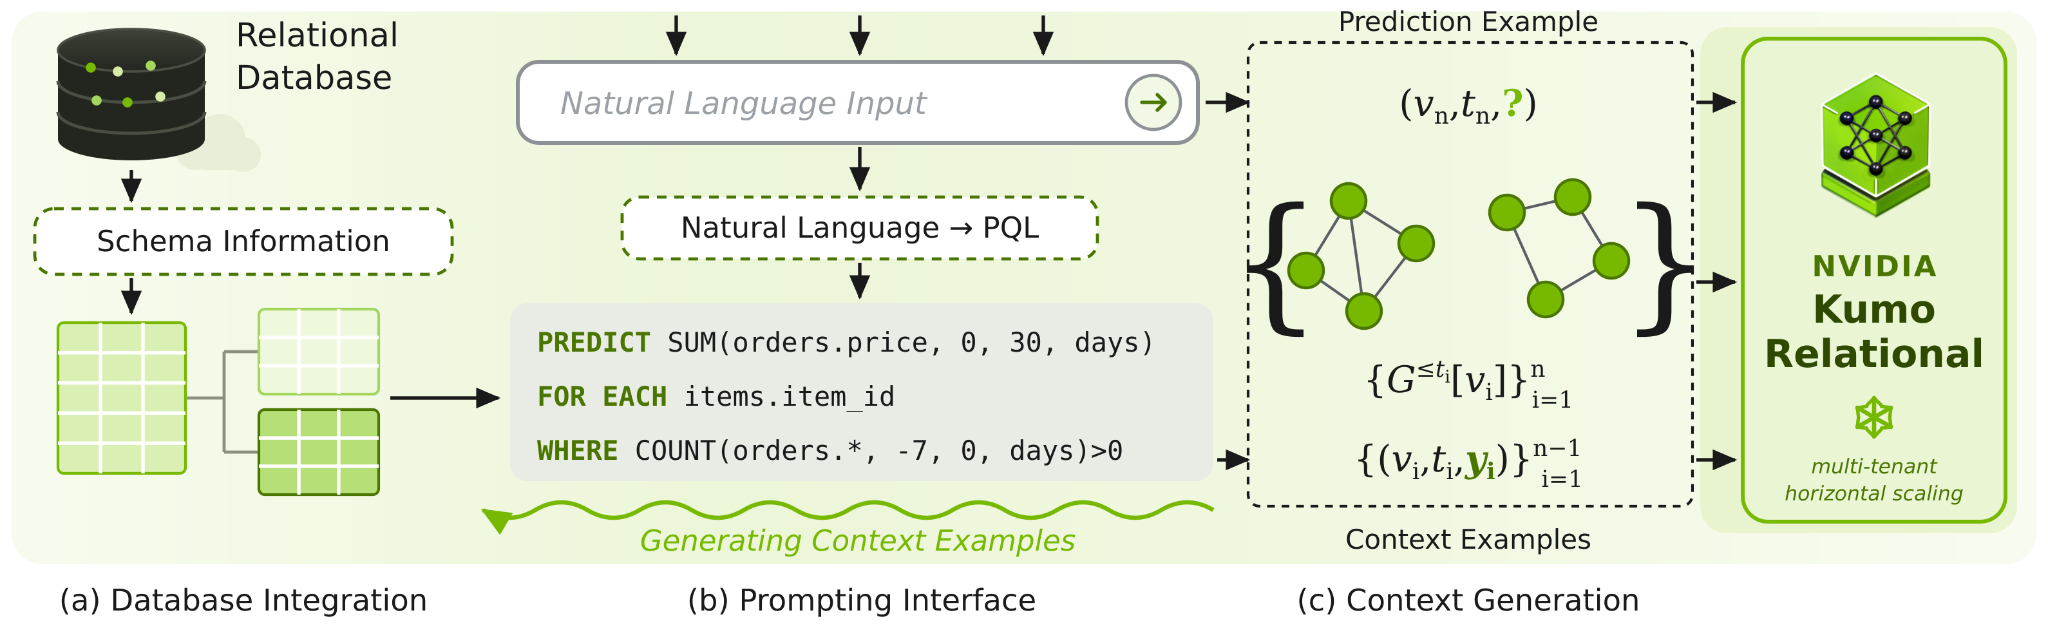
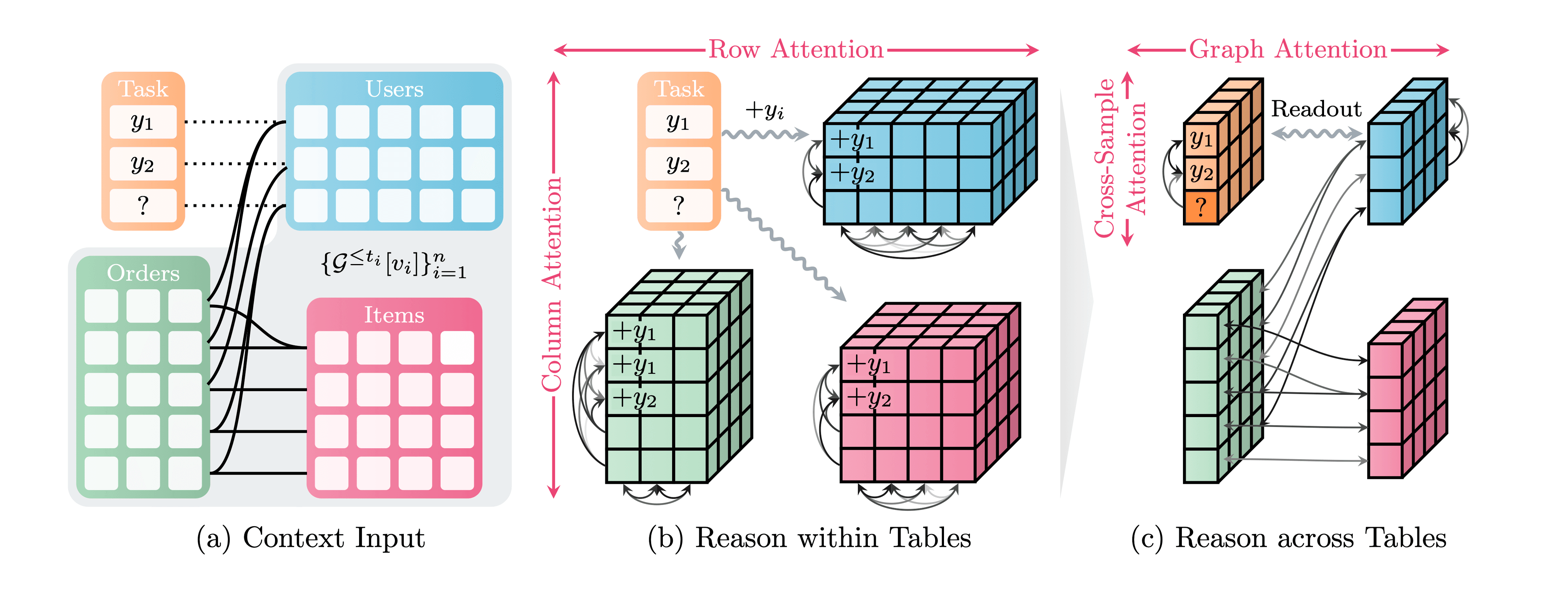
يؤدي النموذج ثلاث مهام ليصل إلى التنبؤ. أولاً، توليد السياق آلياً: تُكتب المهام بلغة Predictive Query Language (PQL)، وهي واجهة تصريحية تحدد فيها ما تريد التنبؤ به لا طريقة حسابه. في المهام الزمنية يعيد النموذج تشغيل حالات القاعدة التاريخية، فيأخذ رسوماً فرعية متمركزة حول الكيان حتى طابع زمني مرجعي، ويحسب الهدف من أحداث تقع بعده، ولا يعرض على النموذج إلا ما سبقه، وهذا يمنع تسرب البيانات. ثانياً، الاستدلال داخل الجداول: شبكة خفيفة تعالج كل جدول بمفرده، وتتناوب بين انتباه الأعمدة (ربط القيم داخل العمود) وانتباه الصفوف (ربط الخصائص داخل الصف)، فتتعلم ما يهم وتُسقط الضجيج قبل أن ينتشر. ثالثاً، الاستدلال عبر الجداول: شبكة أكبر توزع تمثيلات الصفوف على البنية العلائقية عبر graph attention على علاقات المفاتيح الأساسية والأجنبية، متداخلة مع انتباه عابر للعينات بين أمثلة السياق. هنا يحدث الربط بين ملف المستخدم وسجل معاملاته مثلاً. ولأن هذه المرحلة تعمل على تمثيلات الصفوف لا على كل خلية في كل جدول، يتجنب التصميم التكلفة التربيعية ويتوسع إلى سياقات أكبر ورسوم فرعية أعمق.
أما مصدر المعرفة فهو بيانات اصطناعية بالكامل، لأن قواعد البيانات العلائقية المتنوعة اللازمة للتدريب نادراً ما تكون علنية. يمر التدريب المسبق بمراحل تبدأ بجداول منفردة وتنتهي ببنى علائقية معقدة. ويعتمد مولّد البيانات على منهج PluRel (Kothapalli وآخرون، ICML 2026) الذي يمد مولدات الجدول الواحد إلى قواعد بيانات كاملة، وقد شارك أعضاء من فريق Kumo في تطويره وتأليف ورقته. يولّد PluRel كل قاعدة على ثلاث مراحل: مخطط schema، ثم روابط مفاتيح أجنبية بين الصفوف تتكتل كما في البيانات الحقيقية، ثم قيم أعمدة من نماذج سببية بنيوية (Structural Causal Models) فيها اتجاهات زمنية واعتماديات بين الجداول. التوليد خفيف، فبيانات التدريب عملياً بلا حد، وبحسب ورقة PluRel تتبع خسارة التدريب قانون قوة كلما أُضيفت قواعد اصطناعية، مع مكاسب تنتقل إلى القواعد الحقيقية. والنتيجة نموذج يتعلم الفلترة والربط والتجميع عبر الجداول بدل الاعتماد على تجميعات ثابتة، مع إمكانية fine-tuning على مهمة بعينها حين تكون الدقة القصوى هي الهدف.
في التقييم، بحسب الورقة البحثية التي تحمل عنوان KumoRFM-2، اختُبر النموذج على 41 معياراً عبر 15 قاعدة بيانات من RelBench V1 وV2 وSAP SALT و4DBInfer، تغطي التجارة الإلكترونية والطب والمؤسسات والشبكات الاجتماعية والمجال الأكاديمي، ولم يرَ النموذج أياً منها خلال التدريب. وتقول الورقة إنه في SAP SALT يتجاوز مجموعات AutoGluon الكبيرة بـ8% في MRR، ونماذج الأساس الجدولية الحديثة بنحو 25%، وإن fine-tuning يرفع تقدمه على AutoGluon إلى 16% (وفقاً لـ الورقة البحثية على arXiv). ويصمد في الظروف الصعبة: أداء جيد بسياق لا يتجاوز 0.2% من بيانات التدريب، واستقرار عند حذف ما يصل إلى 75% من روابط المفاتيح الأجنبية، وتراجع طفيف عند إضافة أعمدة كثيرة مشوشة (وفقاً لـ الورقة البحثية على arXiv).
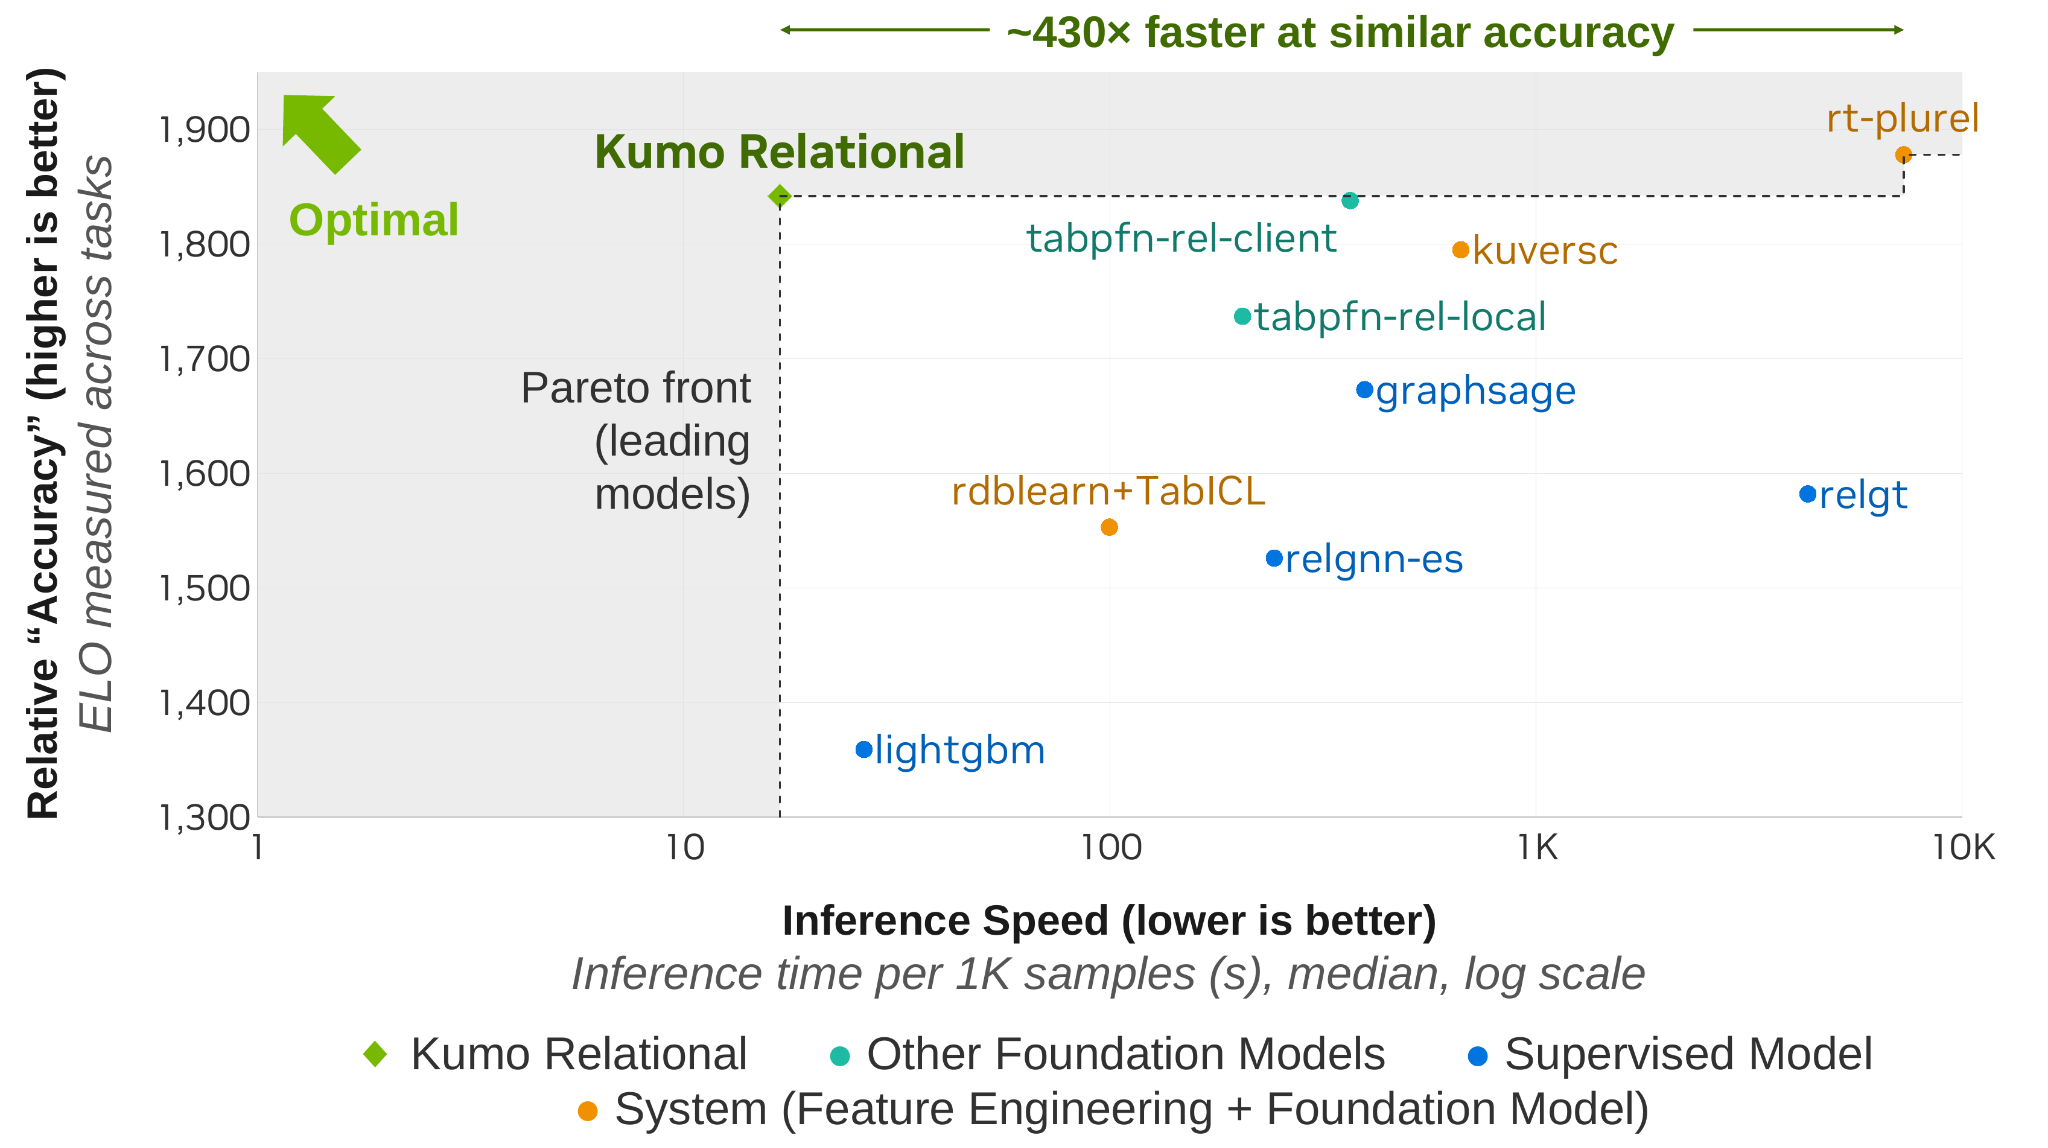
الرسم أعلاه هو أكثر ما يستحق التأمل. على لوحة RelArena-α التي تقارن الأنظمة العلائقية على RelBench V1، يقع Kumo Relational على حد باريتو بين الدقة والكفاءة دون أي ضبط: نحو 17 ثانية لكل 1,000 عينة وتقييم Elo 1,842، بينما يصل صاحب أعلى تقييم، rt-plurel، إلى Elo 1,878 في نحو 7,300 ثانية، أي أبطأ بنحو 430 مرة (وفقاً لـ مدونة NVIDIA على Hugging Face). لاحظ إذن أن النموذج ليس الأدق على الإطلاق في هذه اللوحة، لكنه يقدم دقة قريبة بكلفة زمنية أقل بفارق هائل، وكل نماذج الأساس وأنظمة هندسة الميزات والنماذج الخاضعة للإشراف الأخرى جاءت أقل دقة وأبطأ منه بحسب المدونة.
إذا كنت تريد التجربة بنفسك، فالنموذج متاح في مكتبة structured-data-models المفتوحة المصدر والمبنية للعمل على GPU، وهي المكتبة نفسها التي تشغّل النموذج الشقيق Kumo Tabular. ويمكن تشغيله في الذاكرة، أو عبر موصلات قواعد البيانات والمستودعات، أو عبر محرك رسم بياني مخصص يتعامل مع أكثر من 500 مليار صف باستخدام memory-mapped I/O بسرعة تصل إلى 5 GB/s (وفقاً لـ مدونة NVIDIA على Hugging Face). هذه خطوات الاستخدام كما تصفها المدونة ووثائق NVIDIA الرسمية:
- ثبّت المكتبة في بيئة مزودة بـGPU عبر الأمر
pip install structured-data-models، ثم استوردها بـimport sdm. - حمّل النموذج بـ
model = sdm.models.KumoRelational(device="cuda")، وستُنزَّل الأوزان من Hugging Face Hub تلقائياً عند أول استخدام. - جهّز جدول السياق التدريبي بالمفاتيح الأجنبية والطوابع الزمنية والقيم المستهدفة وامرره عبر
x_contextوy_context، ثم مرر الكيانات المراد التنبؤ بها مع مفاتيحها وطوابعها عبرx_query. - مرر الجداول المرتبطة بكيانات السياق والتنبؤ عبر
related_context_tablesوrelated_query_tables، وراجع أمثلة المكتبة العلائقية التي تتضمن خطوطاً كاملة لـRelBench وSAP SALT وطريقة أخذ عينات الجداول المرتبطة بكل كيان. - إن أردت تشغيله كخدمة منفصلة، انشره بصيغة NVIDIA NIM ووجّه إليه عميل structured-data-models-client من دفتر الملاحظات، ثم اكتب تنبؤك بلغة PQL ليتولى العميل جمع أمثلة السياق والجداول المرتبطة.
- ابدأ باستعلام مركّز على عدد قليل من الجداول ذات الصلة، ثم وسّع الرسم البياني تدريجياً، وانتقل إلى fine-tuning فقط حين تملك مجموعة تدريب كبيرة وتحتاج أقصى دقة.
تعترف NVIDIA بحدود واضحة. يعمل النموذج بأفضل صورة على بيانات فيها علاقات ذات معنى وديناميكيات زمنية، مثل سلوك المستخدمين عبر الوقت. وفي المهام ذات مجموعات التدريب الضخمة جداً قد تتفوق النماذج الخاضعة للإشراف المتخصصة على التنبؤ في السياق، الذي لم يستخدم في المعايير أكثر من 10,000 مثال، ولهذا صُمم خيار fine-tuning. كما يجب أن تكون الإشارات التنبؤية في متناول عدد محدود من القفزات في الرسم البياني، فلن يلتقط النموذج علاقة تبعد عن الكيان مسافة كبيرة. ونضيف من جهتنا تحفظاً جوهرياً: كل الأرقام هنا صادرة عن فريق NVIDIA وأوراقه، والمؤلفون ومنهم Jure Leskovec وMatthias Fey هم أنفسهم من بنوا النموذج ومولّد بياناته، وهذه القصة تستند إلى مصدر وحيد هو NVIDIA وباحثوها، دون تقييم مستقل حتى تاريخ النشر في 21 أكتوبر 2026. كما أن النص المتاح من المدونة ينقطع عند شرح عميل NIM، ولم تذكر المدونة تسعير NIM ولا شروط ترخيص الأوزان. ومع ذلك، نعتقد أن الحجة الاقتصادية هنا أقوى من حجة الدقة: فريق يقضي أسابيع في بناء خط XGBoost لكل سؤال تنبؤي جديد قد يستبدل ذلك باستعلام واحد، وهذا وحده كافٍ ليجرّبه أي فريق بيانات قبل أن يبدأ مشروعه التالي.
المصادر
- NVIDIA Kumo Relational Outperforms Supervised Machine Learning on Relational Data, No Training Required huggingface.co
- KumoRFM-2: Scaling Foundation Models for Relational Learning arxiv.org
- Kumo Relational NIM | NVIDIA Kumo docs.nvidia.com
- Predictive Query Language: A Domain-Specific Language for Predictive Modeling on Relational Databases arxiv.org
- PluRel: Synthetic Data unlocks Scaling Laws for Relational Foundation Models arxiv.org